“아까 말씀드렸잖아요.” 대화형 AI에게 이렇게 말하게 되는 순간이 있습니다. 반대로 몇 마디 앞의 내용을 정확히 받아서 답하면 AI가 대화를 기억한다고 느낍니다. 그런데 그 기억은 어디에 있을까요.
가상의 쇼핑몰 문의 도우미를 생각해 보겠습니다. 고객이 “어제 주문한 상품 언제 와요?”라고 묻고, 답을 들은 뒤 “그럼 주소 바꿀 수 있어요?”라고 이어 묻습니다. 두 번째 질문에는 어떤 주문인지가 빠져 있습니다. 사람 상담원이라면 앞의 대화를 기억해서 답하겠지만, AI는 앞의 대화가 다음 요청에 함께 들어가야만 그 주문을 압니다.
OpenAI API의 대화 상태 관리 방식을 예로 들어, 대화형 AI 기능을 기획하거나 검토할 때 무엇을 정해야 하는지 살펴보겠습니다. 기준은 개발자가 API로 만드는 앱입니다. 챗 서비스가 사용자 정보를 따로 저장해 두는 기억 기능은 다루지 않습니다. 한 대화 안에서 앞의 말이 다음 답으로 이어지는 원리는 챗 서비스도 같아서, 대화가 왜 끊기는지 짐작하는 데는 쓸 수 있습니다.
모델은 요청마다 처음부터 읽습니다
OpenAI의 대화 상태 가이드는 텍스트 생성 요청 하나하나가 독립적이고 상태가 없다고 설명합니다. 모델이 지난 요청을 따로 저장해 두었다가 꺼내 쓰는 것이 아니라는 뜻입니다. 여러 차례 주고받는 대화를 만들려면 이전 메시지를 다음 요청에 함께 넣어야 합니다.
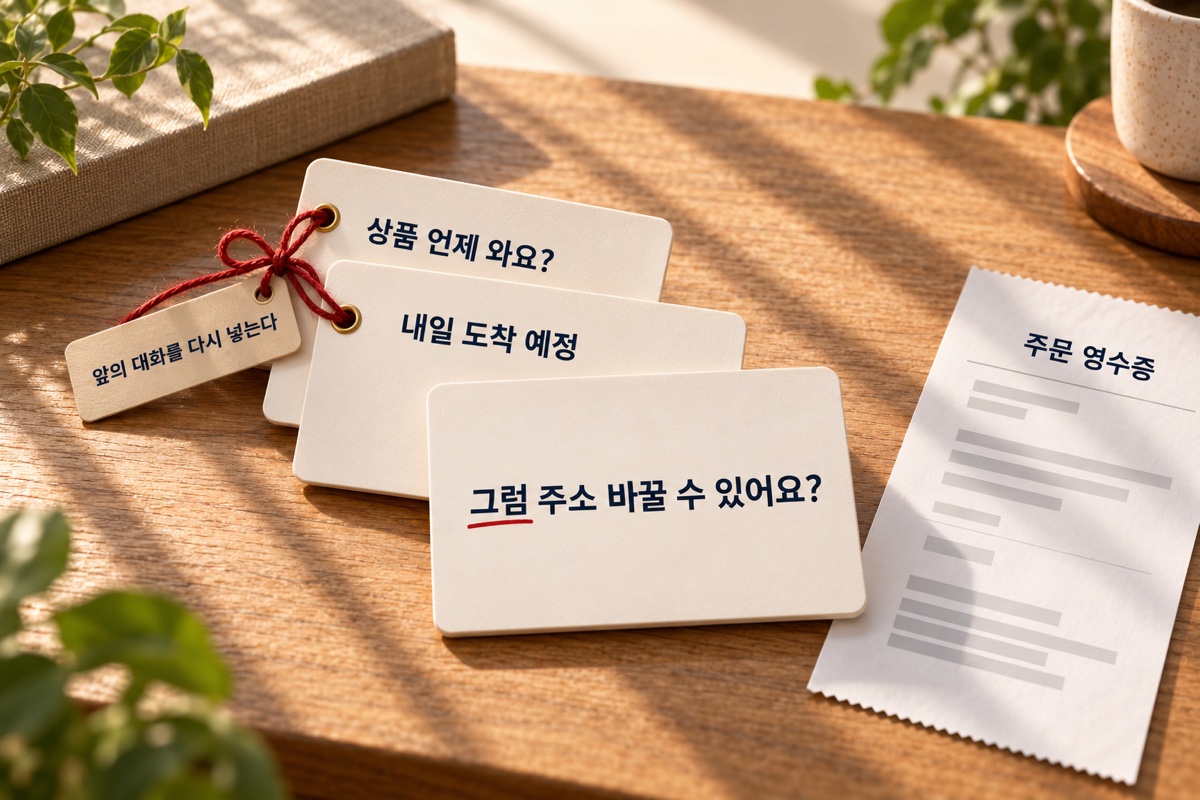
가이드의 기본 방식은 고객 메시지와 AI 답변을 번갈아 다시 보내는 것입니다. 쇼핑몰 예라면 두 번째 요청에 “어제 주문한 상품 언제 와요?”와 그 답, 그리고 새 질문 “그럼 주소 바꿀 수 있어요?”를 함께 넣습니다. 그래야 모델이 ‘그럼’이 가리키는 주문을 압니다.
그래서 ‘AI가 기억한다’는 말은 정확히 말하면 ‘이전 대화가 다음 요청에 다시 들어간다’입니다. 앱이 직접 넣을 수도 있고, 다음 절에서 볼 것처럼 OpenAI 쪽에 이어 붙여 달라고 요청할 수도 있습니다. 어느 쪽이든 어떤 방식으로 무엇을 이어 줄지는 앱이 정합니다. 앞의 대화가 들어가지 않으면 모델은 그 내용을 알 방법이 없습니다.
이어 붙이는 방식마다 기록이 남는 곳이 다릅니다
먼저 두 가지 ‘저장’을 구분해야 합니다. 모델은 요청과 요청 사이에 아무것도 기억하지 않습니다. 하지만 대화 기록은 어딘가에 보관될 수 있습니다. 앱의 서버일 수도 있고, OpenAI 쪽일 수도 있습니다. 기억하는 주체는 모델이 아니라 그 기록을 들고 있는 곳입니다.
가이드는 대화를 잇는 방법을 세 가지로 설명합니다. 첫째는 앞에서 본 것처럼 앱이 이전 메시지를 직접 모아 다시 보내는 방식입니다. 둘째는 previous_response_id입니다. 새 요청에 직전 응답의 ID를 넘기면, 이전 내용을 직접 다시 보내지 않아도 그 응답에 이어지는 대화가 됩니다. 셋째는 Conversations API입니다. 대화 하나를 고유한 ID가 붙은 묶음으로 만들고, 주고받은 메시지 같은 항목을 그 안에 쌓습니다. 가이드는 이 묶음을 다른 세션이나 기기에서도 이어 쓸 수 있다고 설명합니다. 뒤의 두 방식에서는 앱이 ID만 넘기고, 이전 대화를 이어 붙이는 일은 OpenAI 쪽에서 일어납니다.
이 글에서는 OpenAI 쪽에 남는 기록을 두 이름으로 부릅니다. 요청을 보낼 때마다 하나씩 생기는 기록(가이드의 응답 객체)은 ‘응답 기록’, Conversations API로 만든 묶음(가이드의 대화 객체와 그 안의 항목)은 ‘대화 묶음’입니다.
| 직접 다시 보내기 | 이전 응답 ID | 대화 묶음 | |
|---|---|---|---|
| 이전 대화를 넣는 쪽 | 앱 | OpenAI | OpenAI |
| 대화 전체를 보관하는 곳 | 앱 | OpenAI | OpenAI |
| store 켬(기본값): OpenAI에 남는 기간 | 응답 기록 30일 | 응답 기록 30일 | 대화 묶음을 지울 때까지 |
| store 끔: OpenAI에 남는 기록 | 응답 기록 저장 안 함 | 가이드에 없음, 개발자 확인 | 가이드에 없음, 개발자 확인 |
표의 셋째 줄이 보여 주듯, 저장 옵션을 켠 기본값이면 앱이 직접 대화를 모아 보내도 OpenAI 쪽에 아무것도 남지 않는 것은 아닙니다. 가이드에 따르면 응답 기록은 기본으로 30일 동안 저장되고, OpenAI 플랫폼 대시보드의 로그 화면에서 보거나 API로 다시 불러올 수 있습니다. 대화에 담긴 내용이 그대로 보관된다고 보는 편이 안전합니다. 요청에 넣는 저장 옵션인 store를 false로 두면 저장하지 않습니다. 가이드의 직접 다시 보내기 예시는 store를 false로 둔 채 대화를 잇습니다. 이전 응답 ID 방식에서 저장을 끄면 어떻게 동작하는지는 이 가이드에 나와 있지 않아 개발자와 확인해야 합니다.
대화 묶음에는 30일 만료가 없고, 데이터 보관 안내는 지울 때까지 남는다고 적고 있습니다. 대화 삭제 API 설명에는 대화 묶음을 지워도 그 안에 쌓인 항목은 지워지지 않는다고 되어 있습니다. 묶음을 지울 때 항목도 따로 정리하는지 확인해야 합니다.
고객의 주문 정보처럼 개인정보가 섞인 대화라면 어느 방식을 쓰느냐가 곧 그 정보를 어디에 얼마나 남기느냐의 결정이 됩니다.
대화가 길어지면 넣을 수 있는 양에 한계가 옵니다
이전 대화를 계속 이어 붙이면 요청은 점점 커집니다. 가이드는 한 요청에 쓸 수 있는 최대 토큰 수를 맥락 창이라고 부릅니다. 토큰은 모델이 글을 나누어 세는 단위입니다. 이 한도에는 입력뿐 아니라 모델이 만드는 답, 일부 모델에서는 답을 계획하는 데 쓰는 추론 토큰까지 들어갑니다. 한도를 넘으면 답이 잘릴 수 있습니다. 맥락 창의 크기는 모델마다 다르며 가이드의 모델 안내에서 확인할 수 있습니다.
비용도 함께 늘어납니다. 가이드는 previous_response_id로 이어 붙여도 이어진 응답들의 이전 입력 토큰이 모두 입력 토큰으로 과금된다고 밝힙니다. 직접 다시 보내지 않는다고 해서 이전 대화를 공짜로 읽는 것이 아닙니다.
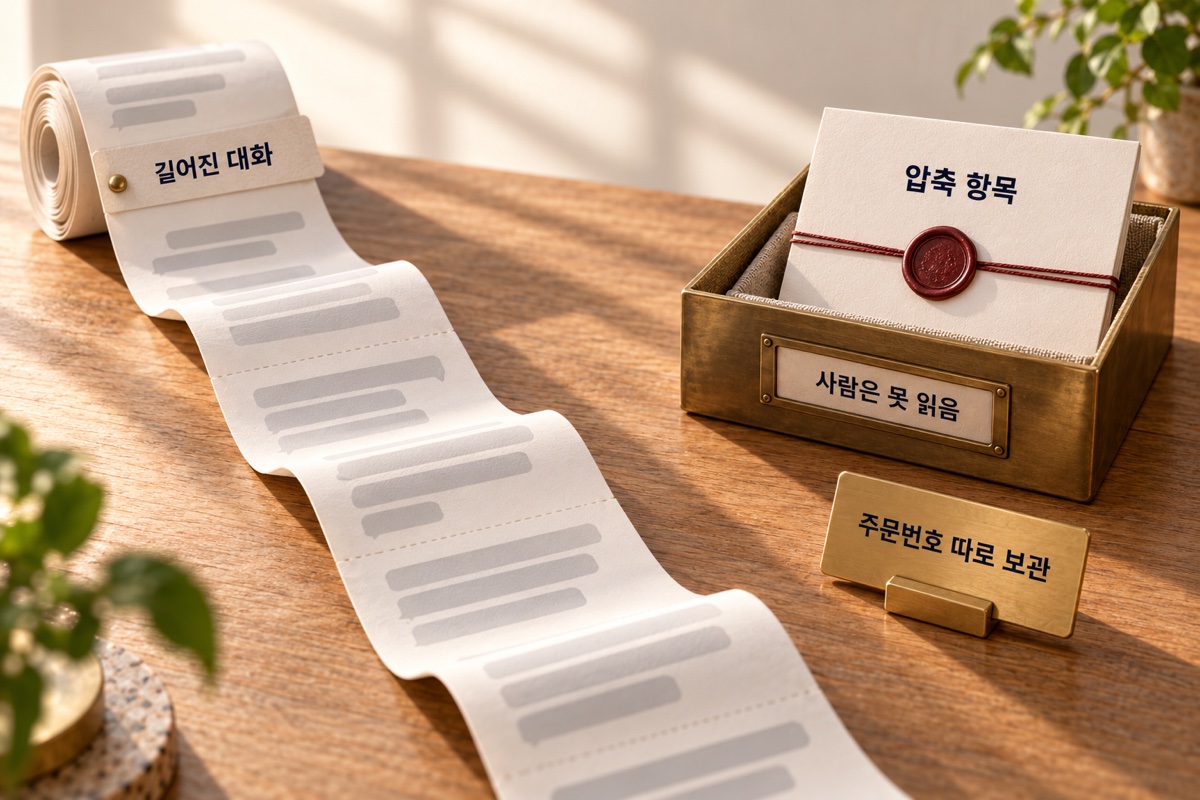
긴 대화를 위해 가이드는 압축(Compaction)을 안내합니다. 압축 가이드에 따르면 개발자가 기준 크기를 정해 두고, 대화가 그 크기를 넘으면 OpenAI 서버가 앞의 대화를 압축 항목 하나로 줄입니다. 다음 요청은 긴 대화 대신 이 압축 항목을 이어받습니다. 이 항목은 암호화되어 있어 사람이 읽을 수 없습니다. 압축 뒤에 어떤 세부가 남았는지 사람이 들여다보고 확인할 수는 없다는 뜻입니다. 대화 초반의 주문번호처럼 끝까지 정확해야 하는 정보라면 대화와 별도로 앱이 따로 보관해 두는 편이 안전합니다.
기억을 기획할 때 정할 것은 세 가지입니다
대화형 AI 기능을 기획한다면 ‘기억하나요’ 대신 세 질문을 먼저 적어 보시길 권합니다. 첫째, 다음 요청에 무엇을 이어 줄 것인가. 대화 전체인지, 주문번호처럼 꼭 필요한 정보만인지 정합니다. 둘째, 그 기록을 어디에 얼마나 남길 것인가. 앱이 보관하는지, OpenAI 쪽 응답 기록이나 대화 묶음에 남기는지, 저장을 끄거나 지울 수 있는지 확인합니다. 셋째, 대화가 길어지면 무엇을 남기고 무엇을 줄일 것인가. 끝까지 정확해야 하는 정보는 무엇인지 미리 고릅니다.
결과를 검토하는 입장이라면 대화 두 개로 점검할 수 있습니다.
점검 1은 앞의 대화가 이어지는지 보는 확인입니다. 첫 메시지에 주문번호 같은 핵심 정보를 하나 넣고, 상관없는 질문을 열 번쯤 주고받은 뒤 ‘그 주문’처럼 앞의 정보를 가리키는 질문을 던집니다.
점검 2는 맥락 창 한도나 압축을 거친 뒤에도 처음 정보가 살아 있는지 보는 확인입니다. 먼저 개발자에게 압축 기준 크기를 듣습니다. 그다음 긴 문서를 여러 번 붙여 넣는 식으로 대화를 그 크기보다 크게 키운 뒤 같은 질문을 합니다.
엉뚱하게 답한다면 모델의 능력을 탓하기 전에 개발자에게 네 가지를 물어봅니다.
- 다음 요청에 이전 대화를 어떤 방식으로 넣나요? (직접 보내기,
previous_response_id, Conversations API) - 응답 기록 저장(
store)을 켜 두었나요? - 대화가 길어지면 잘라 내거나 압축하나요? 압축한다면 기준 크기는 얼마인가요?
- 핵심 정보를 대화와 따로 보관하나요?
이 글은 AI의 도움을 받아 작성했습니다.
참고 자료
이 글의 기능 설명은 2026년 10월 3일 공식 문서 기준입니다.
- OpenAI Conversation state: https://developers.openai.com/api/docs/guides/conversation-state
- OpenAI Compaction: https://developers.openai.com/api/docs/guides/compaction
- OpenAI Data controls in the OpenAI platform: https://developers.openai.com/api/docs/guides/your-data
- OpenAI API reference, Delete a conversation: https://developers.openai.com/api/reference/resources/conversations/methods/delete