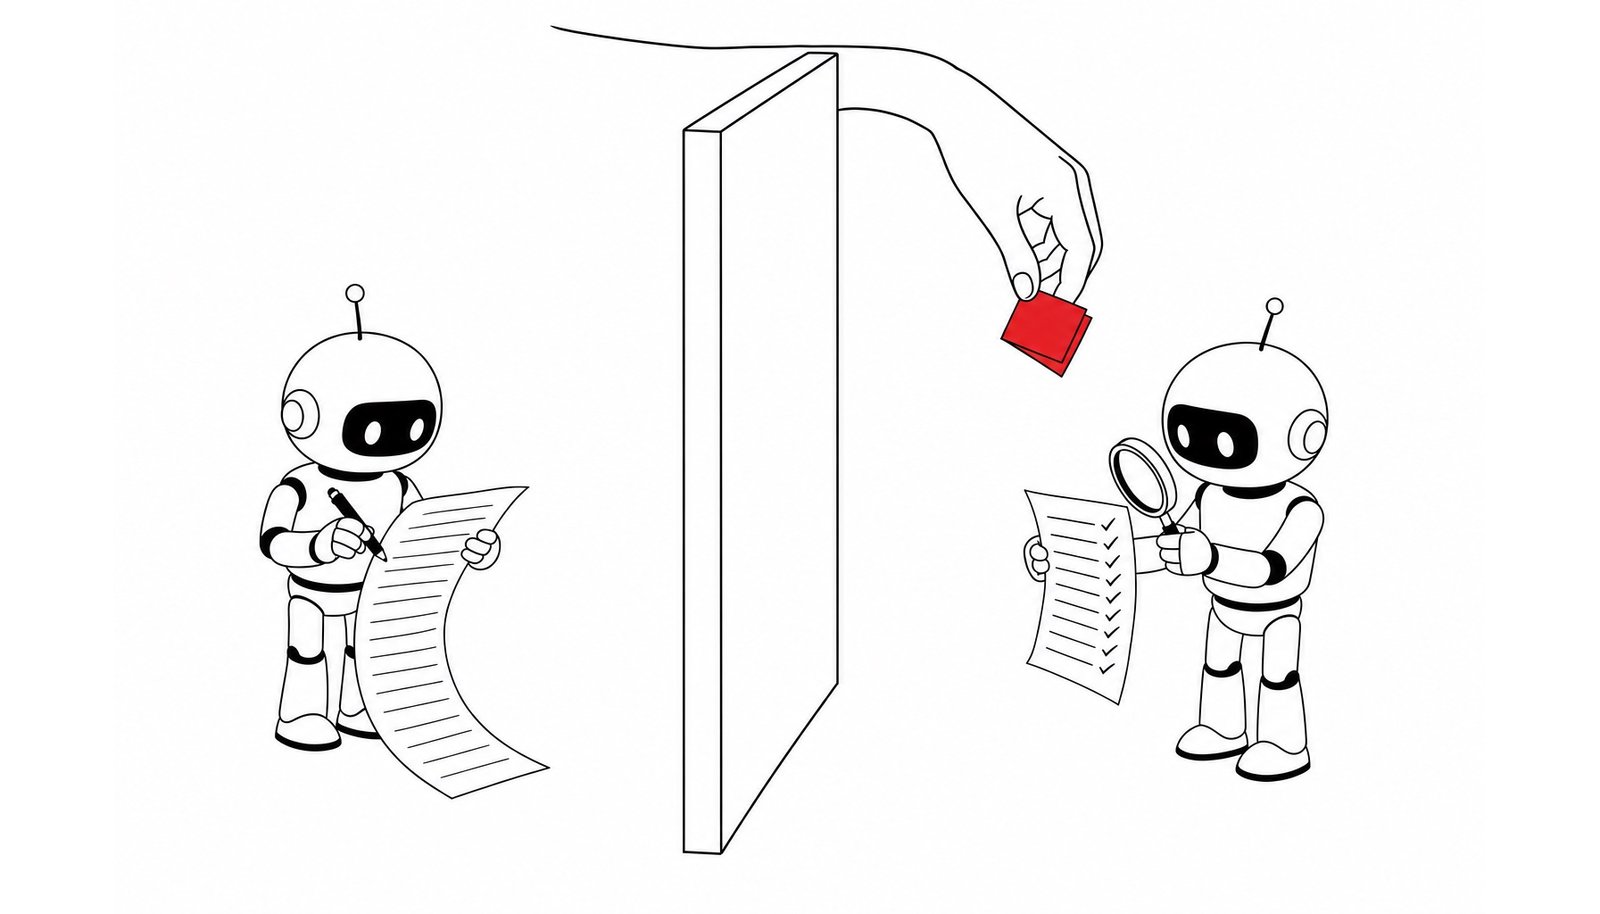
AI 에이전트에게 일을 맡기는 방식이 한쪽으로 모이고 있습니다. 만드는 에이전트와 검사하는 에이전트를 따로 두는 방식입니다. 에이전트 설계 가이드에도, AI 코딩 도구의 모범 사례에도 같은 권고가 적혀 있습니다.
저도 그렇게 바꿨습니다. 지난 글에서는 AI가 스스로 한 점검이 0건이었고, 따로 세운 검사자는 결함을 찾아냈다고 적었습니다.
그런데 지난 한 달 동안 돌린 다른 작업 세 건에서는, 검사자를 따로 세웠는데도 검사가 헛돌았습니다. 두 번은 검사자가 몰라야 할 것을 알고 있었습니다. 한 번은 반대로, 검사자가 무엇을 봤는지를 제가 모르고 있었습니다. 이 글은 그 세 번의 기록입니다.
여러 에이전트 가이드가 만드는 쪽과 보는 쪽을 나누라고 권합니다
Anthropic은 2026년 3월, 긴 작업을 맡는 에이전트의 구조를 설명하는 엔지니어링 글을 냈습니다. 에이전트에게 자기 작업을 평가하게 하면, 사람이 보기에 평범한 결과여도 “자신 있게 칭찬한다”는 관찰이 거기 있습니다. 그래서 일하는 에이전트와 판정하는 에이전트를 나누는 것이 “강한 지렛대”라고 적었습니다. 생성자를 자기비판적으로 만드는 것보다, 따로 둔 평가자를 회의적으로 조정하는 쪽이 훨씬 다루기 쉬웠다고도 했습니다.
연구 쪽 결론도 비슷합니다. 2024년 ICLR(머신러닝 학회)에 실린 연구는 LLM(대규모 언어 모델)이 외부 피드백 없이는 자기 추론을 잘 고치지 못한다고 보고했습니다. 같은 해 다른 연구는 LLM 평가자가 자기 출력에 더 높은 점수를 준다는 것을 측정했습니다.
반대 증거도 있습니다. 같은 모델이 쓰고, 비평하고, 고치게 했더니 과제 성능이 평균 약 20%p 올랐다는 2023년 연구입니다. 결과가 엇갈리는데, 둘을 평균 낼 게 아니라 어떤 조건에서 갈렸는지를 봐야 합니다. 자기 교정 연구를 정리한 2024년 리뷰 논문은 조건을 이렇게 가릅니다. 믿을 만한 외부 피드백을 쓸 수 있는 과제에서는 자기 교정이 잘 되고, 프롬프트로 부른 LLM의 피드백만으로 성공한 사례는 특수한 과제를 빼면 없다고요. 모델을 몇 개로 나누느냐보다, 결과를 판정할 바깥 신호가 있느냐가 갈림길이었습니다. 이 말은 세 번째 사례에서 다시 나옵니다.
사람의 일도 이 방향으로 움직인다는 조사가 있습니다. Microsoft가 2026년 5월에 낸 Work Trend Index는 AI를 업무에 쓰는 지식노동자 2만 명에게 물었습니다. AI가 일을 더 맡을수록 중요해지는 사람의 역량 1위로 “AI 결과물의 품질 관리”(50%)가 꼽혔습니다. 한 기관의 조사이긴 하지만, 검사가 점점 사람과 또 다른 에이전트의 몫이 된다면 그 검사를 어떻게 믿을 만하게 만드느냐가 일하는 방식의 문제가 됩니다.
검사자가 함정을 알고 있으면 전부 맞힙니다
저는 에이전트를 만들면 먼저 가상의 실습 자료로 끝까지 돌려 봅니다. 가상의 회사 규정이나 회의록을 지어내고(이하 합성 자료), 그 안에 일부러 함정을 심습니다. 에이전트가 함정을 몇 개나 찾는지로 성능을 잽니다. 이 시험에서는 규정을 읽고 결함을 찾아내는 에이전트가 곧 검사자이고, 그 결과를 정답지와 맞춰 점수를 매기는 일은 채점이라고 부르겠습니다.
9월 25일 오전에 가상의 도서관 규정으로 이 시험을 했습니다. 결과는 9개 중 9개, 만점이었습니다.
막힌 곳: 자료를 만들라고 시킨 대화와 그 자료를 풀어 본 대화가 같은 대화였습니다. 여기서 대화는 AI와 주고받는 채팅 창 하나를 말합니다. 저는 자료를 만들게 하면서 어떤 종류의 함정을 심으라고 프롬프트에 직접 적었습니다. 정답지 파일은 따로 숨겨 두었지만, 무엇을 심었는지는 검사자가 이미 알고 있었습니다. 시험이 아니라 받아쓰기였던 셈입니다.
만점이 무엇을 놓쳤는지는, 만점을 받은 그 풀이 결과물을 함정 목록 없이 따로 본 검사에서 드러났습니다. 새 대화에서 부른 다른 검사 에이전트가 원문과 대조해 결함 11건을 냈고, 전부 제 정답지에 없는 종류였습니다. 이 11건을 사람이 한 건씩 다시 맞춰 본 기록은 없습니다. 정답지는 규정에 나오는 사람이나 기관을 빠뜨리지 않고 찾았는지만 다뤘는데, 실제 결함은 검사자가 원문을 옮겨 적는 자리에서 나왔습니다. ‘심의’할 수 있는 위원회를 ‘멈출 권한’이 있는 위원회로 적거나, 누가 누구에게 요청하는지 방향을 뒤집거나, 앞으로 할 일을 이미 한 일로 적는 식이었습니다.
같은 날 다시 돌렸습니다. 이번에는 어떤 함정을 어디에 심을지를 자료 만드는 쪽에 맡겼고, 고를 수 있는 함정 종류에 ‘원문대로 옮기기’를 더했습니다. 저는 무엇이 심겼는지 모르는 채로, 다른 대화에 풀게 하고 또 다른 대화에 채점을 맡겼습니다. 자료는 새로 만들어졌고 빠진 사람 찾기 함정 5개, 옮기기 함정 5개가 들어갔습니다.
점수는 내려갔지만, 이쪽이 처음으로 제가 믿을 수 있는 숫자였습니다.
원래 문제만 본 확인자가, 통과한 기능의 빈자리를 찾았습니다
두 번째는 가상의 채용 관리 서비스에 면접관 배정 기능을 붙이는 작업이었습니다. 문제 정의부터 구현까지 에이전트가 이어서 만들고, 마지막에 검사 에이전트가 인수기준(이 기능이 완료됐다고 볼 조건)대로 동작하는지 테스트했습니다.
검사 에이전트가 맡은 인수기준 6개가 모두 통과했고, 자동 검사 29개도 두 번 돌려 모두 통과했습니다. 여기서 끝냈다면 완료로 기록했을 겁니다.
그런데 검사 에이전트가 들고 있던 것은 인수기준이었습니다. 인수기준은 만드는 쪽이 쓴 기획 문서에서 나옵니다. 만든 쪽이 문제를 잘못 옮겼다면 검사자도 같은 기준으로 통과를 줍니다. 검사자는 따로 세웠지만, 검사자가 쥔 잣대는 만드는 쪽이 건넨 것이었습니다.
그래서 확인 에이전트를 하나 더 세웠습니다. 이 확인자에게는 처음 문제를 정의한 문서 한 장만 줬고, 인수기준은 보여 주지 않았습니다. 확인자는 면접관 입장에서 화면을 따라가 보고, 면접관이 자기에게 배정된 지원자를 화면에서 볼 방법이 없다는 것을 찾았습니다. 설계 단계에서 면접관에게는 화면을 열어 주지 않기로 한 결정이 원래 문제와 부딪히고 있었습니다.
결정을 고쳐 면접관에게 기존 화면을 읽기 전용으로 열어 줬습니다. 같은 확인자에게 다시 보이자 문제 정의에 적은 성공 기준 3개와 제약 2개를 모두 채웠습니다.
예전에 테스트가 전부 통과해도 무엇을 안 봤는지 물어야 한다고 쓴 적이 있습니다. 그때는 같은 일을 입력만 바꿔 여러 번 시켰습니다. 이번에는 검사자가 쥔 잣대 자체를, 만드는 쪽이 건드리지 않은 문서로 바꿨습니다.
0건은 깨끗하다는 뜻이 아니었습니다
세 번째는 합성 자료가 아니라, 8월 말에 실제로 쓴 학회 논문 원고였습니다. 원고를 비평할 에이전트를 둘 따로 세웠습니다. 두 에이전트는 결과를 내지 않고 대기 상태만 되풀이하다가 비평을 끝내지 못하고 돌아왔고, 보고된 발견은 0건이었습니다. 원고를 다 읽고 낸 0인지, 읽다 만 0인지는 결과만 보고는 알 수 없었습니다.
그사이 저는 학회의 투고 규정을 검사 스크립트로 옮겼습니다. 참고문헌마다 본문 인용 표시가 있는지, 서식과 분량이 규정에 맞는지를 세는 스크립트입니다. 앞에서 본 연구가 말한 바깥 신호가 바로 이런 것입니다. 그런데 이 스크립트도 처음에는 “0건, 통과”를 냈습니다. 확인해 보니 파일 경로가 틀려서 아무것도 읽지 않은 채 낸 0이었습니다.
경로를 고치고 다시 돌리자 규정 위반 7건이 나왔습니다. 참고문헌은 12건인데 본문의 인용 표시가 0건이었던 것도 여기서 나왔습니다. 에이전트의 0도, 스크립트의 첫 0도 ‘깨끗하다’가 아니라 ‘안 봤다’였습니다. 검사자가 실제로 무엇을 읽었는지 모르면, 결과만으로는 둘을 가릴 수 없었습니다.
독립 검증 표준의 세 가지 독립 가운데, AI에게 남는 것은 하나였습니다
만든 사람이 아닌 사람이 검사해야 한다는 원칙은 AI보다 훨씬 오래됐습니다. 소프트웨어 검증과 확인을 다루는 IEEE 1012 계열 표준은 독립 검증의 독립성을 세 가지로 나눕니다. NASA의 독립 검증 조직이 소개하는 정의를 빌리면 이렇습니다.
만든 사람이 아닌 사람이 검사해야 한다는 원칙은 AI보다 훨씬 오래됐습니다.
기술적 독립은 검사자가 개발자와 무관하게 자기 전문성으로 평가하는 것입니다. 관리적 독립은 검증 책임을 구현 조직과 다른 조직에 두는 것이고, 재정적 독립은 검증 예산을 개발 조직과 독립된 곳에 두는 것입니다. AI 위험관리 쪽도 같은 원칙을 둡니다. 미국 NIST의 AI 위험관리 프레임워크는 그 시스템의 일선 개발자가 아니었던 내부 전문가나 독립 평가자가 정기 평가에 참여하는 것을 측정 항목의 하나로 두었습니다.
표준이 말하는 기술적 독립은 전문성의 독립입니다. 여기서부터는 제 해석입니다. 사람 검사자의 전문성이 독립적일 수 있었던 바탕에는, 개발팀이 아는 것을 검사자는 모른다는 사정이 깔려 있었다고 봅니다. 다른 조직, 다른 예산의 검증팀은 개발팀이 어떤 함정을 알고 있는지, 기획 회의에서 무엇을 정했는지 원래 모릅니다. 사람 팀에서는 관리적 독립과 재정적 독립을 갖추면 이 모름이 대개 따라왔습니다.
AI 검사자에게는 관리적 독립도 재정적 독립도 성립하지 않았습니다. 만드는 에이전트와 검사하는 에이전트를 부르는 사람이 둘 다 저이고, 조직도 예산도 하나입니다. 지난 글에서는 만든 대화와 검사하는 대화를 떼어 거리를 만들었습니다. 이번에 알게 된 것은 대화를 떼어도 새는 길이 하나 남는다는 점입니다. 부르는 사람의 프롬프트입니다. 도서관 시험에서는 제가 아는 함정 목록이 그 길로 흘렀고, 채용 서비스에서는 만드는 쪽이 쓴 인수기준이 흘렀습니다. 그래서 AI 검사자에게는 기술적 독립의 바탕인 모름을, 제가 프롬프트에서 따로 만들어 줘야 했습니다.
되돌린 결정: 무엇을 넘길지보다 무엇을 빼고 넘길지를 먼저 정합니다
처음에는 검사자에게 넘기는 프롬프트를 친절하게 쓰는 것이 좋은 줄 알았습니다. 어떤 함정이 있는지, 어떤 기준으로 보면 되는지 알려 줄수록 검사가 정확해질 거라고 생각했고, 함정 목록도 제가 정해서 넘겼습니다. 이 결정을 되돌렸습니다.
이제는 검사자를 부르기 전에 한 가지를 먼저 정합니다. 이 검사자가 모르고 있어야 할 것이 무엇인가입니다. 함정 시험이면 무엇을 심었는지를 모르게 하고, 함정 고르기는 자료 만드는 쪽에 맡깁니다. 기능 확인이면 인수기준을 빼고 문제 정의만 줍니다. 그리고 논문 원고 일을 겪은 뒤로는, 검사 결과와 함께 몇 개의 파일과 몇 개의 항목을 읽었는지도 적게 하기로 했습니다. 0건이 나와도 읽은 수가 0이면 통과로 적지 않습니다.
아직 남은 문제: 정답지도, 검사자도 결국 제 쪽에서 나옵니다
앞의 두 사례는 제가 지어낸 합성 자료였습니다. 세 번째는 실제 원고였지만, 사람 검토자가 본 결과와 나란히 비교한 적은 없습니다. 실제 업무 자료로 사람이 처음부터 끝까지 돌려 본 적도 아직 없습니다.
정답지도 결국 출제자인 제 추측입니다. 도서관 재실행 때 채점하는 대화에 ‘정답지가 틀렸다고 보이면 적어라’라는 칸을 열어 두자, 정답지에 대한 이견이 3건 나왔습니다. 제가 명단에서 기관 하나를 빠뜨린 것 같은 실수였습니다. 모르게 하는 것만으로는 부족하고, 정답지를 반박할 자리까지 열어 둬야 했습니다.
검사자들이 모두 같은 회사의 모델이라는 점도 남아 있습니다. 대화를 나누고 정보를 가려도, 같은 모델이 같은 쪽으로 틀리는 경우는 이 방식으로 잡히지 않습니다. 반대로 Anthropic의 같은 글은 모델 능력 안쪽의 쉬운 과제에서는 평가자가 불필요한 부담이었다고도 적었습니다. 모든 일에 검사자를 붙일 일은 아니고, 어디에 붙일지는 아직 사례를 쌓으며 가르고 있습니다.
마치며: ‘검사자를 따로 세웠나’가 아니라 ‘검사자가 무엇을 모르나’
AI 에이전트와 일하는 방식은 만드는 쪽과 보는 쪽을 나누는 방향으로 가고 있고, 저도 그게 맞다고 봅니다. 다만 나누는 것만으로는 충분하지 않았습니다. 사람 검사자는 조직을 나누면 모르는 것이 저절로 생겼지만, AI 검사자는 부르는 사람이 모르게 해 줘야 비로소 모릅니다.
다음에 검사 에이전트나 새 대화에 검토를 맡길 때, 붙여 넣기 전에 한 번만 멈춰 보시길 권합니다. 이 검사자가 몰라야 할 것을 한 줄로 적고, 그것을 뺀 채로 넘기는 겁니다. 시험이면 심어 둔 함정의 목록, 기능 확인이면 만드는 쪽이 쓴 인수기준일 가능성이 큽니다. 돌려받은 결과가 0건이면, 통과로 적기 전에 검사자가 몇 개를 읽었는지부터 확인하는 것도 같은 이유입니다.
이 글은 AI의 도움을 받아 작성했습니다.
참고 자료
- Anthropic, Harness design for long-running application development (2026): https://www.anthropic.com/engineering/harness-design-long-running-apps
- Anthropic, Building effective agents (2024): https://www.anthropic.com/engineering/building-effective-agents
- Google Cloud, Choose a design pattern for your agentic AI system: https://docs.cloud.google.com/architecture/choose-design-pattern-agentic-ai-system
- Claude Code, Best practices: https://code.claude.com/docs/en/best-practices
- Huang 외, Large Language Models Cannot Self-Correct Reasoning Yet (ICLR 2024): https://arxiv.org/abs/2310.01798
- Panickssery 외, LLM Evaluators Recognize and Favor Their Own Generations (2024): https://arxiv.org/abs/2404.13076
- Madaan 외, Self-Refine: Iterative Refinement with Self-Feedback (2023): https://arxiv.org/abs/2303.17651
- Kamoi 외, When Can LLMs Actually Correct Their Own Mistakes? (TACL 2024): https://arxiv.org/abs/2406.01297
- Microsoft, 2026 Work Trend Index: https://www.microsoft.com/en-us/worklab/work-trend-index/agents-human-agency-and-the-opportunity-for-every-organization
- NASA, IV&V Overview: https://www.nasa.gov/ivv-overview/
- IEEE 1012-2024, Standard for System, Software, and Hardware Verification and Validation: https://standards.ieee.org/ieee/1012/7324/
- NIST, AI RMF Playbook, Measure: https://airc.nist.gov/airmf-resources/playbook/measure/