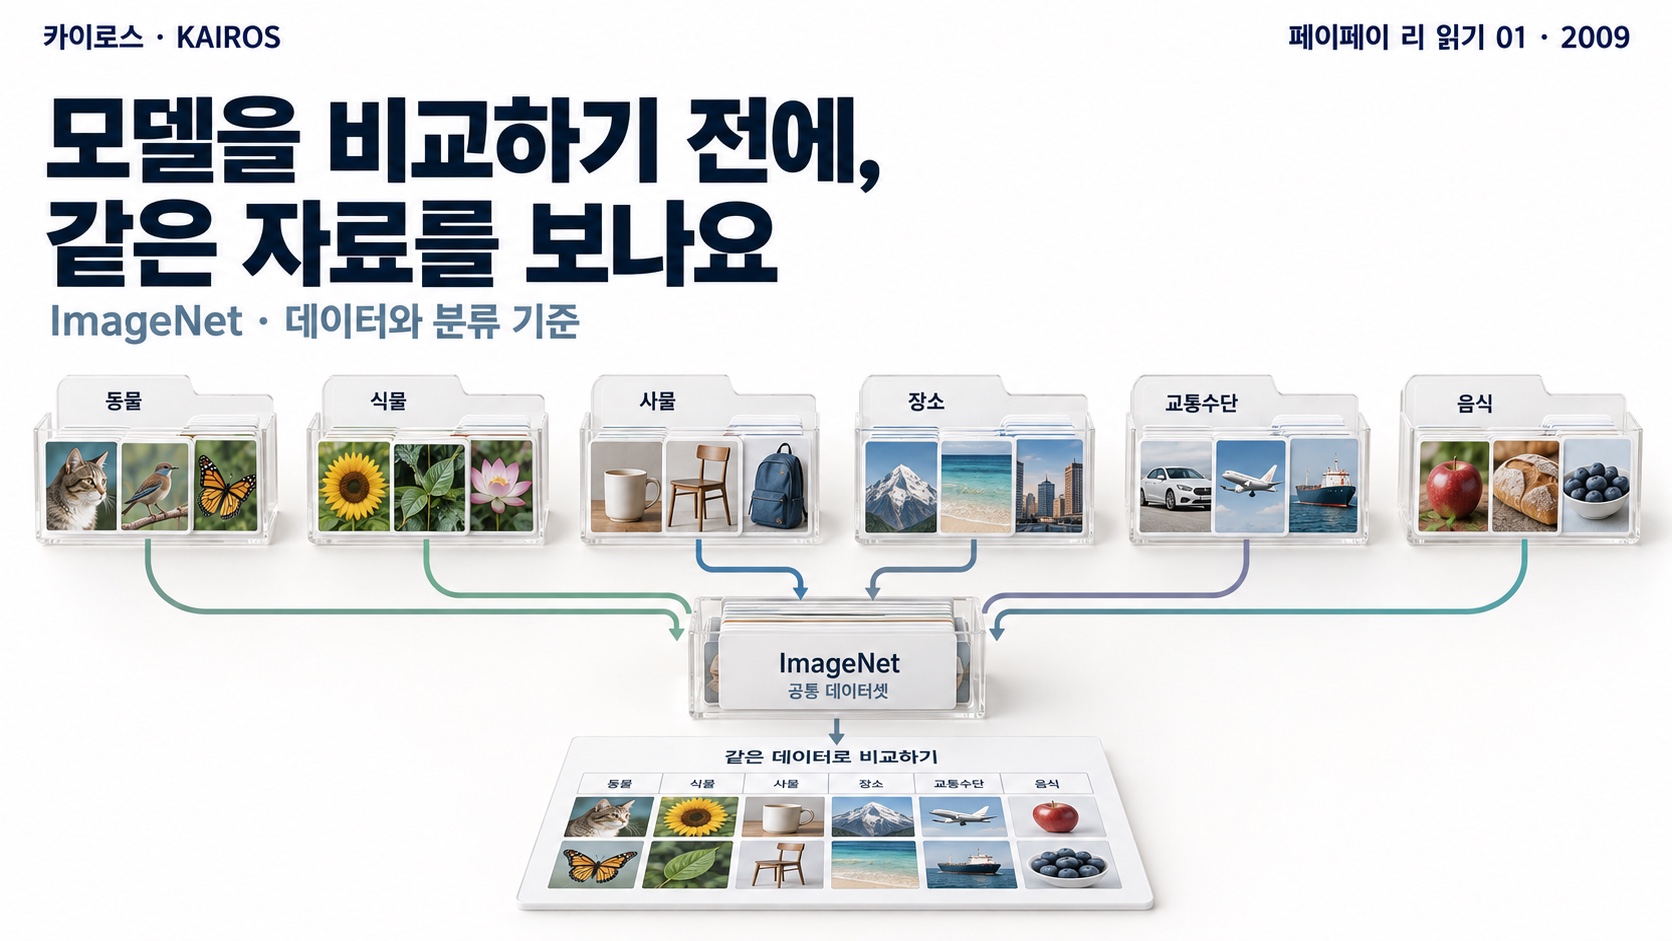
서로 다른 AI 모델 두 개를 시연하면 누구나 더 좋아 보이는 쪽을 고를 수 있습니다. 그러나 입력 자료가 다르고, ‘정답’의 기준이 사람마다 다르다면 그 선택은 무엇을 비교한 것일까요. 모델을 고르기 전에 함께 볼 자료와 이름 붙이는 방식이 필요합니다.
페이페이 리 읽기의 첫 원문은 지아 덩, 웨이 동, 리처드 소처, 리자 리, 카이 리, 리 페이페이가 함께 쓴 2009년 ImageNet 논문입니다. 공동 연구를 한 사람의 단독 발명으로 부르지 않으면서, 이 논문이 왜 데이터의 구조를 연구 문제로 삼았는지 살펴보겠습니다.
ImageNet은 사진을 모으는 데서 그치지 않았습니다
논문은 인터넷의 풍부한 이미지를 연구에 쓸 수 있도록 정리하는 문제를 다룹니다. 저자들은 WordNet의 개념 계층을 바탕으로 이미지를 분류하는 데이터베이스를 제안했습니다. ImageNet 공식 설명에는 이미지의 사람 주석과 품질 확인도 명시되어 있습니다. 목표에는 이미지 인식 알고리즘의 학습뿐 아니라 비교와 평가를 위한 자료를 제공하는 일도 있었습니다. 이 논문만으로 이후 모든 컴퓨터 비전 성과의 원인을 ImageNet 하나에 돌릴 수는 없습니다.
자료가 많아도 이름과 기준이 흔들리면 서로 다른 연구 결과를 공정하게 비교하기 어렵습니다. 논문은 데이터 수집을 단순한 준비 작업이 아니라 연구를 가능하게 하는 토대로 다뤘습니다.
업무용 AI에도 비교할 자료의 경계가 필요합니다
여기서부터는 카이로스의 해석입니다. 가상의 서비스팀이 고객 문의 분류용 AI 두 개를 비교한다고 해 봅시다. 하나에는 쉬운 문의를, 다른 하나에는 예외가 많은 문의를 넣으면 결과를 비교할 수 없습니다. 같은 문의를 써도 ‘환불’, ‘취소’, ‘배송 변경’의 뜻을 팀마다 다르게 쓰면 정답표가 흔들립니다.
그래서 모델 평가 전에 세 가지를 적어야 합니다. 어떤 문의를 넣을지, 각 범주의 뜻이 무엇인지, 판단이 갈리는 문의는 누가 결정할지. 여기에 개인정보나 고객 자료를 함부로 넣지 않는 경계도 포함됩니다. 이는 ImageNet의 수집 절차를 그대로 따라 하자는 뜻이 아니라, 평가 자료의 이름과 품질을 사람이 책임져야 한다는 업무 적용 제안입니다.
이번 주 과제: 같은 자료로 비교할 수 있는지 확인합니다
AI 도구 두 개 또는 같은 도구의 두 설정을 비교할 업무 하나를 고릅니다. 사용 권한이 있는 공개·합성 사례 세 건을 만들고, 각 사례의 기대 결과와 애매한 부분을 적습니다. 두 도구에 같은 사례를 넣은 뒤, 점수보다 먼저 정답표에서 의견이 갈리는 곳을 찾습니다.
완료 기준은 승자를 고르는 것이 아닙니다. 다음 사람이 같은 세 사례를 보고 같은 기준으로 결과를 판단할 수 있는가입니다. 다음 편에서는 이 자료가 공동 벤치마크로 쓰일 때 어떤 종류의 협업이 가능해지는지 읽습니다.
이 글은 AI의 도움을 받아 작성했습니다. 공동 저자의 기여를 한 사람에게 귀속하지 않고, 연구 결과와 업무 사례를 구분했습니다.
AI의 도움을 받아 작성하고 원문 주장과 업무 해석을 구분했습니다. 대표 이미지는 카이로스가 생성한 개념 이미지이며 실제 ImageNet 분류표의 재현이 아닙니다.