새 프로젝트를 시작할 때 아이디어는 쉽게 늘어납니다. 문제는 아이디어가 부족해서가 아니라, 후보를 만드는 일과 후보를 판단하는 일을 같은 회의에서 뒤섞는 것입니다. 그때 목소리가 큰 제안이 검토를 통과한 제안처럼 보이기도 합니다.
허사비스 읽기의 첫 원문은 데미스 허사비스 등이 공동 저자로 참여한 2016년 AlphaGo 논문입니다. 바둑이라는 매우 넓은 선택 공간에서 AlphaGo가 어떤 역할을 나누어 움직였는지를 읽고, 업무에서 선택과 평가를 구별하는 질문을 만들어 보겠습니다.
AlphaGo는 다음 수의 후보와 현재 판의 평가를 나눴습니다
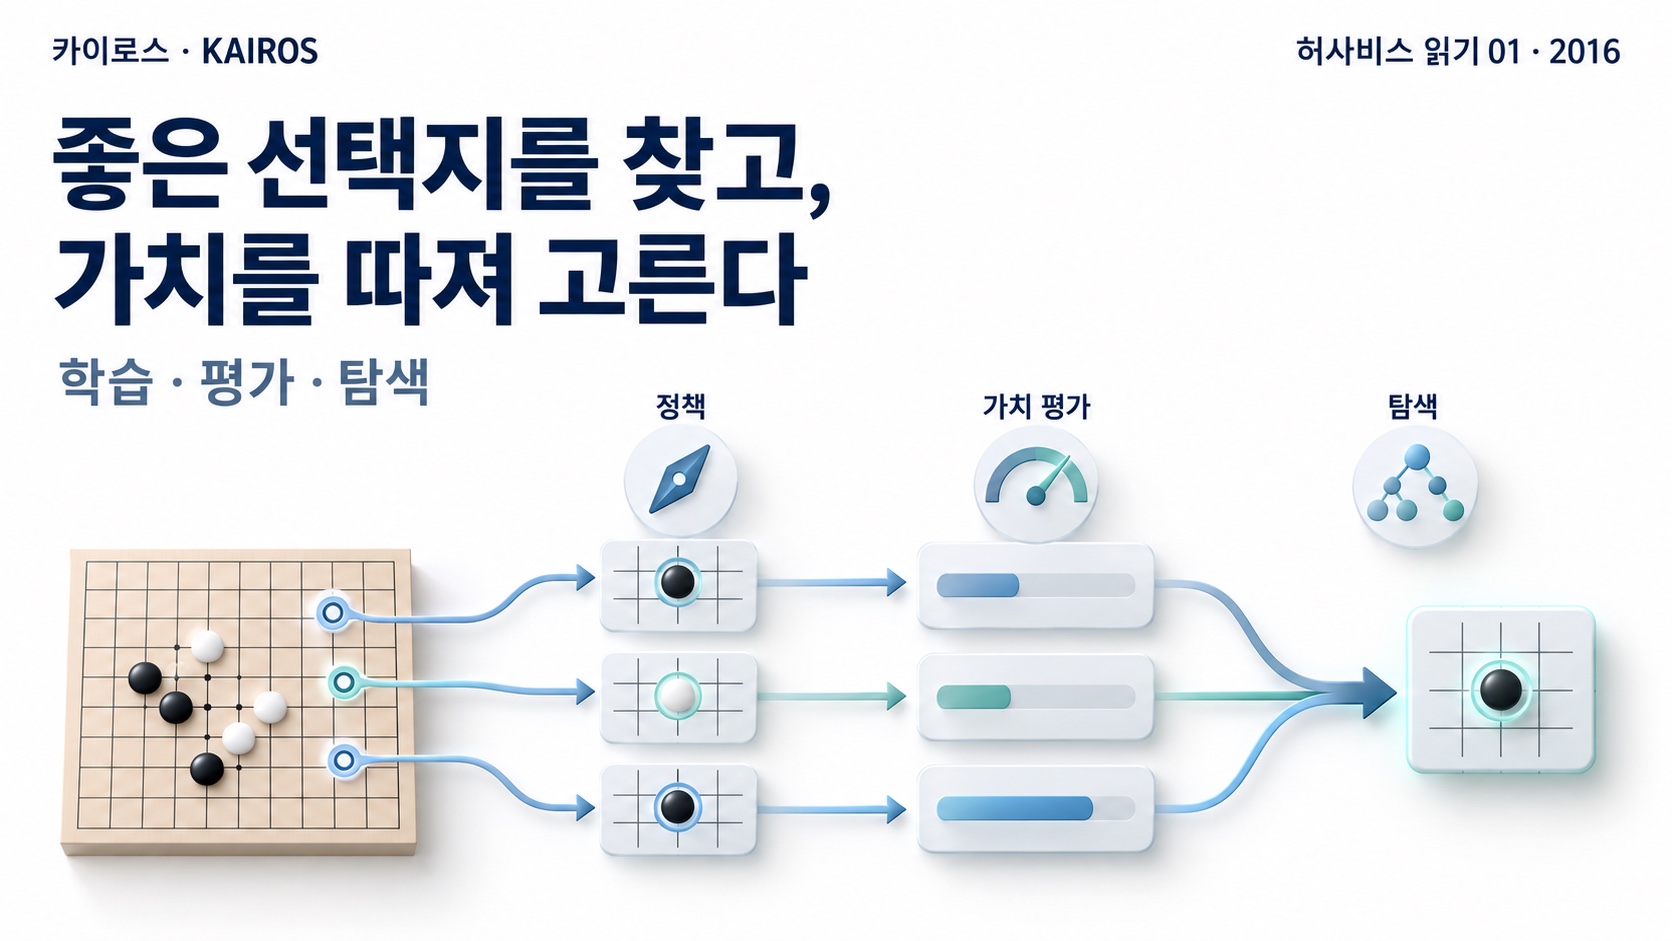
논문은 바둑에서 가능한 수가 많고 판의 좋고 나쁨을 평가하기 어렵다는 문제를 다룹니다. 저자들은 다음 수를 고르는 데 쓰는 정책 네트워크, 판의 승리 가능성을 평가하는 가치 네트워크, 후보를 탐색하는 트리 탐색을 결합했습니다. 사람의 기보를 이용한 학습과 자기 대국의 강화학습도 함께 사용했습니다. 이는 바둑을 푸는 특정 시스템의 설계와 평가입니다. 어떤 조직의 의사결정 방식이 검증됐다는 뜻은 아닙니다.
이 연구에서 업무 담당자가 배울 만한 지점은 “좋은 선택을 한 번에 직감한다”는 묘사가 아니라, 서로 다른 기능을 구별해 실험했다는 사실입니다. 후보 생성, 후보 평가, 다음 탐색이 각각 다른 질문입니다.
우리 회의에도 세 종류의 질문이 있습니다
여기서부터는 카이로스의 해석입니다. 제품팀이 고객 문의 자동화 방안을 검토한다고 가정해 보겠습니다. 실제 고객 프로젝트의 결과가 아닌 가상 사례입니다.
첫 질문은 “가능한 방법이 무엇인가”입니다. 문의 유형을 분류할지, 답변 초안을 도울지, 사람에게 넘길지를 후보로 적습니다. 둘째는 “각 방법을 무엇으로 판단할까”입니다. 속도뿐 아니라 잘못된 답변의 비용, 담당자가 수정할 수 있는지, 고객이 이의를 제기할 경로가 있는지를 봅니다. 셋째는 “아직 모르는 것을 어디서 확인할까”입니다. 낮은 위험의 문의 몇 건을 별도로 시험할 수 있습니다.
바둑에는 승패라는 뚜렷한 결과가 있습니다. 업무의 고객 가치와 책임은 한 점수로 환원하기 어렵습니다. 그러므로 AlphaGo의 방식을 그대로 가져오는 대신, 우리가 무엇을 평가하지 못하는지 드러내는 데 이 구분을 씁니다.
이번 주 과제: 선택 회의의 세 칸을 만듭니다
지금 결정을 기다리는 안건 하나를 고릅니다. 종이에 후보, 판단 기준, 추가 확인 세 칸을 만들고 각 칸에 적어도 한 줄씩 씁니다. 기준 칸에는 속도나 비용과 함께 실패했을 때 영향을 받는 사람도 적습니다. 회의가 끝나면 채택한 안보다 확인하지 못한 가정을 먼저 읽어 봅니다.
완료 기준은 팀이 같은 안을 고르는 것이 아닙니다. 다른 안을 고르더라도 어떤 근거와 어떤 미확인 질문 때문에 판단이 갈렸는지 설명할 수 있어야 합니다. 다음 편에서는 사람의 기존 기보에 기대지 않고 배우려 했던 AlphaGo Zero를 읽습니다.
이 글은 AI의 도움을 받아 작성했습니다. 바둑 연구 결과와 업무 적용 제안을 분리했습니다.
AI의 도움을 받아 작성하고 원문 주장과 업무 해석을 구분했습니다. 대표 이미지는 카이로스가 생성한 개념 이미지입니다.