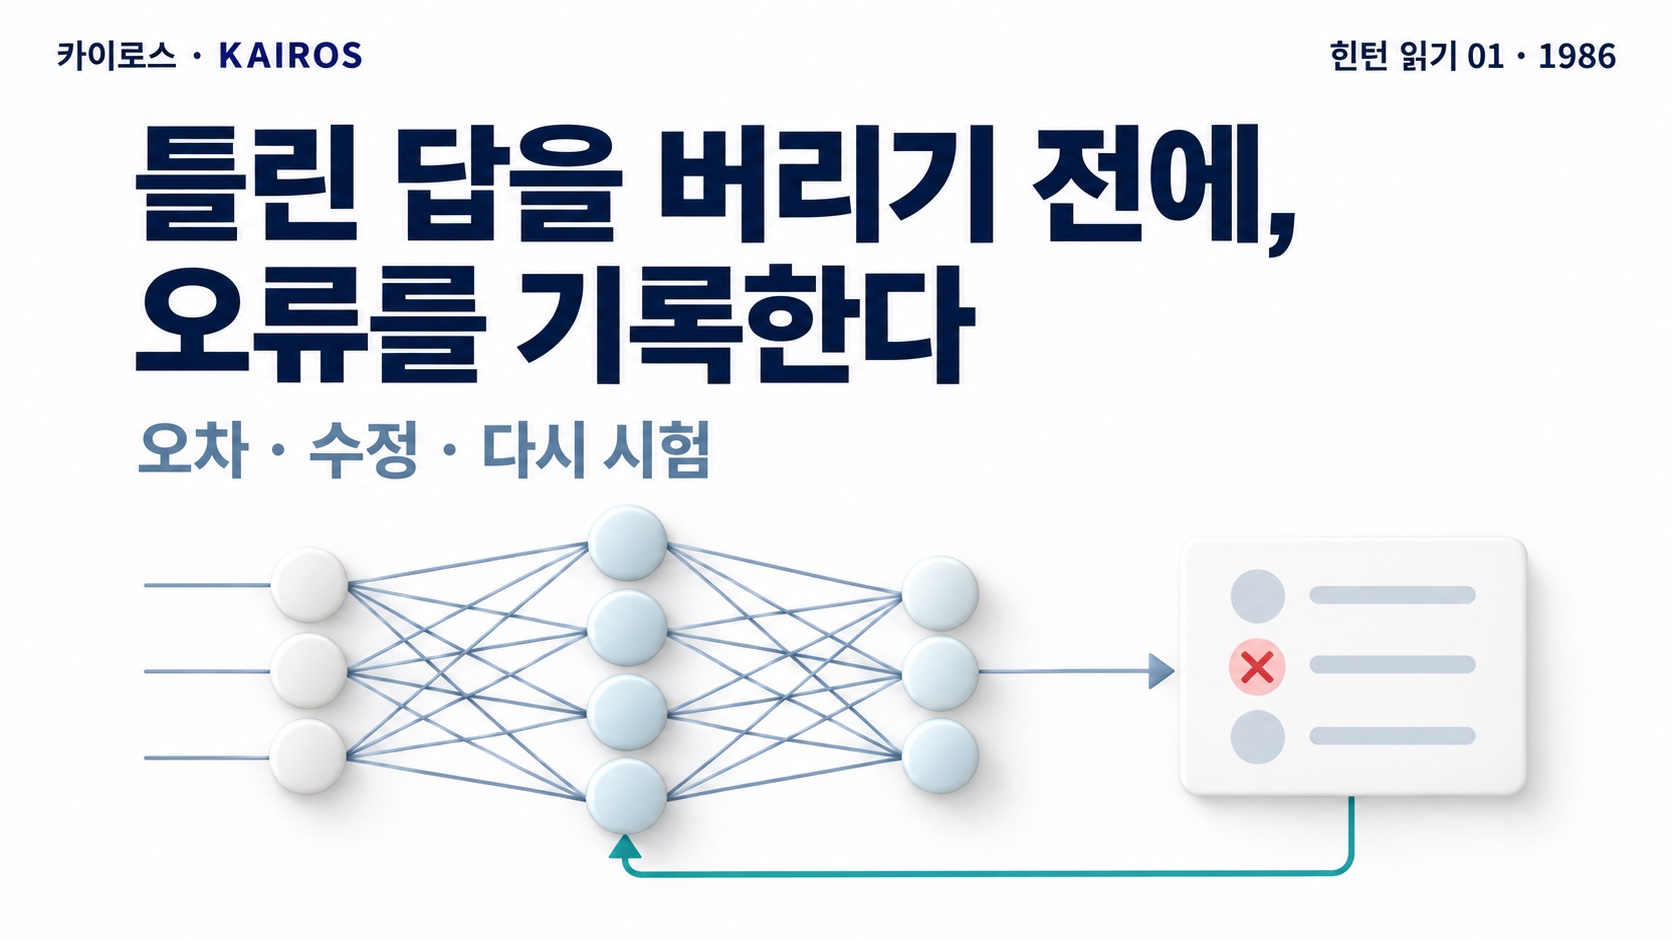
AI가 틀린 답을 내놓으면 새 문장을 넣어 다시 시도하기 쉽습니다. 두 번째 답이 그럴듯하면 첫 번째 실패는 대화창 아래로 밀려납니다. 그러나 다음에도 비슷한 질문이 온다면, 실패를 지우는 것만으로는 우리 판단이 나아지지 않습니다.
힌턴 읽기의 첫 자료는 데이비드 럼멜하트, 제프리 힌턴, 로널드 윌리엄스의 1986년 논문 「Learning representations by back-propagating errors」입니다. 제목에 있는 ‘오류에서 배우기’를 곧바로 조직의 회고법으로 받아들이기 전에, 논문이 실제로 다룬 것과 업무에서 덧붙이는 해석을 나눠 보겠습니다.
논문은 오차를 이용해 내부 연결을 조정했습니다
논문은 신경망이 원하는 출력과 실제 출력 사이의 차이를 이용해 연결 가중치를 조정하는 학습 절차를 설명합니다. 눈에 보이는 입력과 출력 사이에 있는 내부 표현도 이 과정을 통해 바뀔 수 있음을 보여 줍니다. 저자 셋이 함께 쓴 연구이며, 오류가 생기면 AI가 스스로 그 이유를 언어로 설명한다는 주장은 아닙니다.
신경망의 가중치 갱신과 사람이 업무 규칙을 수정하는 방식은 다릅니다. 이 차이를 지킨 상태에서 남는 질문은 하나입니다. 틀린 결과를 봤을 때, 우리는 무엇을 바꿀 근거를 얻었는가?
재시도 기록만으로는 수정할 자리가 보이지 않습니다
여기서부터는 카이로스의 제안입니다. 가상의 고객 문의 분류를 생각해 봅시다. AI가 환불 문의를 배송 문의로 분류했습니다. “다시 분류해”라고 재시도하면 이번 한 건은 바로잡힐 수 있습니다. 그러나 오류를 만든 조건이 남지 않으면 다음 문의에서 반복될 수 있습니다.
이때 기록할 것은 모델의 ‘생각’이 아닙니다. 사람이 관찰한 입력과 출력입니다. 원문에서 환불을 뜻한 대목, AI가 붙인 분류, 올바른 분류 기준, 아직 확인하지 못한 예외를 네 칸에 적습니다. 학습 데이터나 프롬프트를 바꿀 권한이 있는지, 운영 규칙으로 보완해야 하는지도 따로 결정합니다.
| 관찰 | 판단 |
|---|---|
| 어떤 입력에서 어떤 출력이 나왔나 | 우리 기준상 왜 틀렸나 |
| 비슷한 사례가 더 있나 | 수정할 위치와 책임자는 어디인가 |
이번 주 과제: 실패 한 건을 수정 가능한 기록으로 바꿉니다
AI 결과 중 실제로 확인한 오류 하나를 고릅니다. 민감한 원문은 공개 자료나 합성 자료로 바꿉니다. 위의 네 칸을 채운 뒤, “같은 오류가 다시 나오면 누가 어디서 알 수 있는가”를 한 줄로 씁니다. 지금 당장 모델을 다시 학습시킬 필요는 없습니다.
완료 기준은 AI가 이후에 절대 틀리지 않는다는 약속이 아닙니다. 다음에 같은 오류가 발생했을 때 알아보고 고칠 수 있는 기록이 생겼는가입니다. 다음 편에서는 공동 저자들과 함께 쓴 AlexNet을 공통 평가 기준이라는 관점에서 읽습니다.
이 글은 AI의 도움을 받아 작성했습니다. 신경망의 학습 절차와 사람의 업무 회고를 동일한 것으로 설명하지 않았습니다.
AI의 도움을 받아 작성하고 원문 주장과 업무 해석을 구분했습니다. 대표 이미지는 카이로스가 생성한 개념 이미지입니다.