9월 마지막 두 주에 코딩 모델 두 개가 나왔습니다. Anthropic의 Claude Opus 5.5가 9월 22일, OpenAI의 GPT-6.1 Sol이 9월 29일입니다. 두 회사 발표문에 똑같이 나오는 말이 있습니다. 토큰을 덜 쓰고 비용이 줄었다는 말입니다.
숫자를 나란히 놓으려다 멈췄습니다. Anthropic은 Opus 5.5가 전작 Opus 5보다 약 5분의 1 비용으로 더 잘 풀었다고 했고, OpenAI는 GPT-6.1 Sol이 전작 GPT-6 Sol보다 작업당 비용을 약 76% 줄였다고 했습니다. 둘 다 자기 전작과 비교한 숫자입니다. 두 회사 발표문 어디에도 서로를 비교한 숫자는 없었고, 벤치마크 이름도 달랐습니다.
저는 두 도구를 구독으로 매일 씁니다. 저에게 토큰 효율은 청구서가 아니라 주간 사용 한도가 언제 바닥나느냐의 문제입니다. 다만 한도가 무엇을 얼마나 세는지는 공개된 자료가 없어서, 이 글은 같은 사용량을 각 회사 공식 단가로 환산해 비교했습니다. 발표 수치를 옮기는 대신, 같은 일을 두 도구에 직접 시켜 본 기록입니다.
01같은 과제 세 개를 두 도구에 두 번씩 시켰습니다
조건은 이렇습니다. 한쪽은 Claude Code에 Opus 5.5, 다른 쪽은 OpenAI의 코딩 도구 Codex에 GPT-6.1 Sol입니다. 생각의 깊이를 정하는 설정(effort)은 둘 다 중간인 기본값으로 두었습니다. 둘 다 제가 평소 쓰는 설정 그대로입니다.
과제는 일부러 제 일과 닮게 만들었습니다. 첫째는 ERP(전사 자원 관리 시스템)에서 내보낸 날짜와 금액을 정리하는 코드의 버그 수정입니다. 둘째는 주문 내역 파일을 고객별, 월별 합계로 묶는 작은 프로그램을 새로 만드는 일입니다. 셋째는 청구서 계산 코드를 고치지 말고 리뷰만 하는 일입니다. 자료는 전부 가상으로 만들었고 고객명도 지어낸 이름입니다.
채점은 도구가 못 보는 곳에서 했습니다. 첫째와 둘째 과제는 작업 폴더 밖에 숨겨 둔 테스트로 돌렸고, 셋째 과제는 제가 심어 둔 결함 4개를 몇 개 찾았는지로 셌습니다. 자기가 통과할 시험을 자기가 고르면 점수가 의미를 잃기 때문입니다.
02품질은 거의 같았고, 한 번 갈린 곳은 예시만 보고 규칙을 만든 자리였습니다
버그 수정은 네 번 모두 숨은 테스트 22개를 다 통과했습니다. 코드 리뷰도 네 번 모두 심어 둔 결함 4개를 다 찾았습니다. 버그 수정 과제에서 테스트 파일을 고쳐 통과시킨 경우는 한 번도 없었습니다.
갈린 곳은 둘째 과제 한 번이었습니다. 과제 설명에는 날짜 형식 예시로 “2026.10.15”가 있었습니다. Claude의 두 번째 실행은 이 예시에 맞춰 월이 두 자리인 경우만 읽었고, 숨은 테스트의 “2026.1.5”에서 멈췄습니다. Codex는 두 번 모두 한 자리 월까지 읽었습니다. 두 번 중 한 번이라 모델 차이로 단정할 수는 없습니다. 다만 예시를 규칙으로 착각하는 실수는 사람에게도 흔한 실수라, 과제 설명에 예외를 적어 두는 쪽이 싸다는 것은 분명합니다.
말투는 뚜렷하게 달랐습니다. 코드 리뷰에서 Codex는 결함 4개만 한 줄씩 적고 끝냈습니다. Claude는 같은 4개에 더해 “추정”이라고 표시한 지적을 한두 개 더 붙였고, 직접 실행해서 틀린 값을 재현했다고 밝혔습니다. 출력 토큰이 Claude 쪽에서 2.4배 많았던 이유 중 하나로 보입니다. 리뷰를 받는 사람에게는 이 추가분이 도움일 수도 있고 소음일 수도 있습니다.
03처음에는 모델이 여섯 배 효율적이라고 읽었습니다
한 번 실행을 각 회사 공식 단가로 환산하니 Claude Code 쪽이 평균 0.37달러, Codex 쪽이 0.06달러였습니다. 6.2배입니다. SiliconANGLE 기사에서 본 “Sol이 Opus 5.5의 3분의 1 토큰”이라는 말과 겹쳐서, 처음에는 모델 자체가 그만큼 효율적이라고 읽었습니다.
그런데 토큰을 항목별로 나눠 보니 그림이 달랐습니다. 입력 토큰 총량은 Claude가 평균 20만, Codex가 14만으로 Claude 쪽이 40%쯤 많은 데 그쳤습니다. 출력은 2.4배 차이였지만 출력이 비용에서 차지하는 몫은 13%였습니다. 비용의 78%는 한 항목에서 나왔습니다. 실행을 시작할 때 기본 문맥 약 3만 6천 토큰을 캐시(다음 요청에서 다시 읽으려고 저장해 두는 사본)에 처음 쓰는 값이었습니다.
두 회사는 캐시 값을 받는 방식이 다릅니다. Anthropic 가격 문서를 보면 Opus 5.5는 1시간 캐시를 쓸 때 100만 토큰당 8달러, 읽을 때 0.2달러를 받습니다. 한 번 쓰고 여러 번 읽어야 본전이 나는 구조입니다. OpenAI는 쓰기 값을 따로 받지 않고, GPT-6.1 Sol의 캐시 입력은 100만 토큰당 0.1달러입니다. 제 실험처럼 한 번 시키고 끝나는 짧은 실행에서는 앞의 구조가 불리합니다. 1시간짜리 캐시인데도 Claude Code 6회 실행 모두 처음부터 다시 썼는데, 그 이유는 확인하지 못했습니다. 실행마다 작업 폴더가 달라 기본 문맥의 앞부분이 조금씩 바뀌었기 때문으로 추정만 합니다. 하루 종일 한 세션에서 대화를 이어 가면 같은 쓰기 값이 여러 번 나눠지므로 차이는 줄어듭니다.
Claude 쪽에서 첫 캐시 쓰기 항목만 빼면 0.082달러로, Codex의 0.060달러와 비슷해집니다. 다만 이것은 한쪽에서만 짐 값을 뺀 비교입니다. Codex 쪽 짐 값은 새 입력과 섞여 있어 따로 떼어 내지 못했고, 양쪽에서 다 빼면 차이는 이보다 커집니다.
정리하면 비용 차이는 두 가지가 곱해진 결과입니다. 하나는 매 실행 싣는 짐의 크기이고, 다른 하나는 그 짐에 매기는 값입니다. Codex도 기본 문맥을 2만 2천 토큰 싣지만, 따로 받는 저장 값이 없고 새 입력(100만 토큰당 2달러)으로 계산합니다. 그마저 일부는 앞선 실행이 남긴 캐시에서 0.1달러로 읽혀, 한 번 실행의 새 입력은 평균 1만 9천 토큰이었습니다. Claude Code는 같은 자리에서 8달러짜리 캐시 쓰기를 합니다. 짐에 매기는 값은 제가 바꿀 수 없지만, 짐의 크기는 바꿀 수 있습니다. 어림셈 하나를 해 봤습니다. 두 회사의 토큰을 같은 단위로 놓는다는 가정 아래, 짐을 Codex와 같은 2만 2천 토큰으로 줄였다고 치면 6.2배는 약 4.3배가 됩니다. 뒤에 적을 이유로 이 가정은 정확하지 않으니 숫자보다 방향만 읽어 주시길 바랍니다. 짐을 줄여도 차이는 크게 남고, 남는 쪽은 같은 크기의 짐에 붙는 단가와 모델이 일하는 양입니다. 짧게 시키고 끝나는 일이 많다면 짐을 줄이는 것과 별개로 어떤 도구에 맡길지도 함께 따져야 합니다.
04그 짐에는 제가 직접 실어 둔 몫도 들어 있었습니다
짐의 크기를 따로 재려고 “ok”라고만 답하라고 시켜 봤습니다. Claude Code는 이 한 마디에 3만 5천 토큰을 실었고, Codex는 2만 2천 토큰을 실었습니다. 도구가 기본으로 싣는 지시문과 도구 설명에, 제가 전역으로 걸어 둔 지시문이 더해진 값입니다.
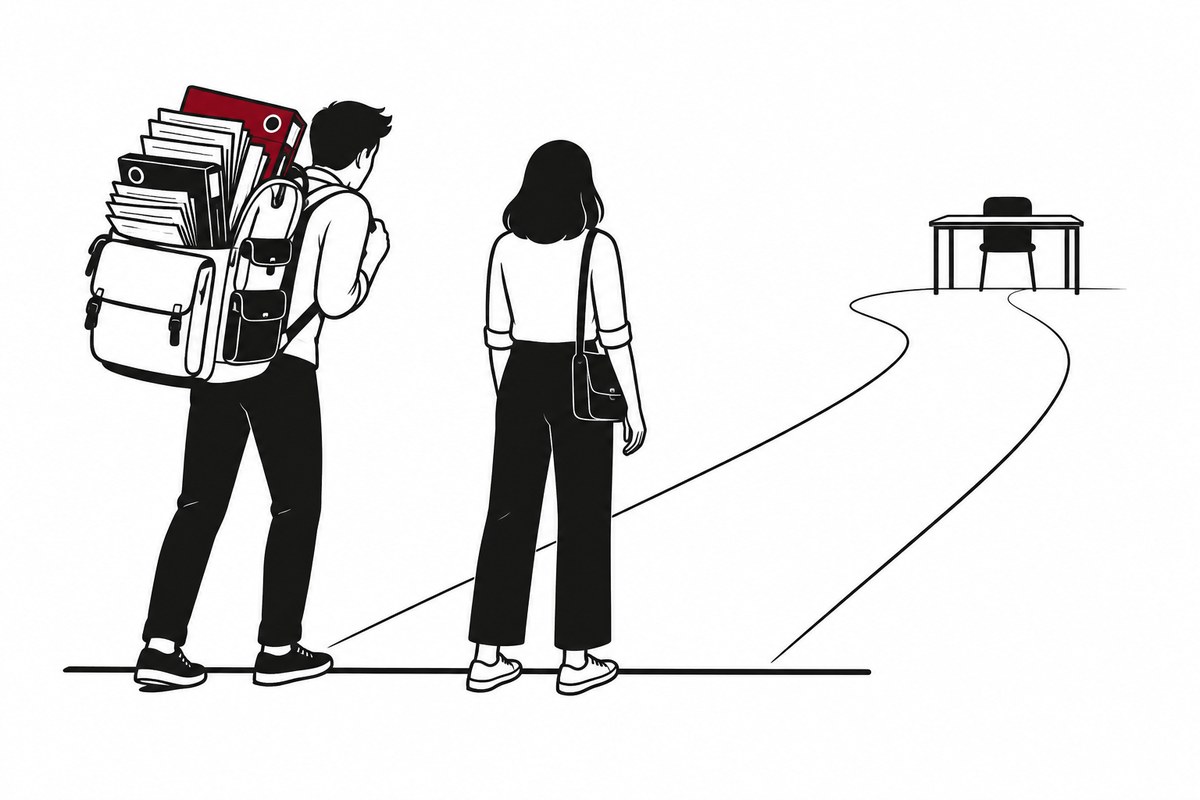
앞에서 본 첫 캐시 쓰기 3만 6천 토큰은 대부분 이 짐으로 보입니다. 과제 설명이 조금 더해져 “ok” 때보다 약간 많습니다. 제 Claude Code에는 모든 세션에 붙는 지시문이 약 24KB 있습니다. 홈 폴더의 CLAUDE.md와 거기서 불러오는 문서로, 일하는 방식과 금지 규칙을 몇 달 동안 쌓은 것입니다. Codex 쪽 같은 자리(AGENTS.md)의 지시문은 1.7KB입니다. 한글이 섞여 토큰으로 정확히 환산하지는 못했지만, 크기 차이는 열 배가 넘습니다. 같은 사람이 같은 일을 시키는데, 한쪽에만 두꺼운 서류철을 매번 들려 보내고 있었던 셈입니다. 이 실험에서 Claude Code가 비싸게 나온 이유의 일부는 Claude가 아니라 제 설정이었습니다. 다만 그 일부가 정확히 얼마인지는 다음 절에 적은 대로 아직 재지 못했습니다.
품질 기준으로 소프트웨어를 볼 때 ISO/IEC 25010은 제품 품질 특성 가운데 하나로 성능 효율성을 둡니다. 저는 도구를 고를 때 이 칸을 속도로만 읽어 왔습니다. 그런데 AI 도구에서는 같은 칸에 매 실행 들어가는 기본 문맥의 양이 들어옵니다. 그리고 그 양은 모델이 아니라 쓰는 사람이 상당 부분을 정합니다.
05아직 확인하지 못한 것이 있습니다
깨끗한 설정의 Claude Code가 기본으로 싣는 양은 재지 못했습니다. 빈 설정으로 띄우면 다시 로그인을 요구했고, API 키로 띄우는 길은 유료라 쓰지 않았습니다. 그래서 3만 5천 토큰 가운데 정확히 얼마가 제 몫인지는 아직 모릅니다.
회사가 다르면 토큰 수를 그대로 비교하기도 어렵습니다. Anthropic 문서는 Opus 4.7 이후 모델이 쓰는 토크나이저(글을 토큰으로 자르는 규칙)가 이전 토크나이저보다 같은 글을 약 30% 더 많은 토큰으로 자른다고 밝힙니다. OpenAI와 비교한 숫자가 아니라, 자르는 규칙만 바뀌어도 같은 글의 토큰 수가 그만큼 달라진다는 뜻입니다. 그래서 두 도구의 우열은 토큰 수가 아니라 환산 비용과 테스트 통과로 판단했습니다. 앞 절의 토큰 수는 짐의 크기를 가늠하는 용도로만 읽어 주시길 바랍니다. 구독 사용 한도가 캐시 쓰기를 달러 환산과 같은 무게로 세는지도 공개 자료에서 확인하지 못했습니다. 그래서 이 글의 달러 숫자를 한도가 줄어드는 속도로 그대로 옮겨 읽지는 않으시길 바랍니다. 표본도 과제당 2회뿐입니다. 이 숫자는 제 환경에서 나온 숫자이고, 모델 순위가 아닙니다.
06마치며
‘어느 모델이 토큰을 아끼나’가 아니라 ‘매번 싣는 짐에 얼마가 붙나’였습니다. 발표 수치는 모델과 모델을 비교하지만, 제가 내는 비용은 짐의 크기와 그 짐에 붙는 단가가 곱해진 값이었습니다. 단가는 회사가 정하고, 짐의 크기는 제가 정합니다. 이번 어림셈으로는 짐을 줄여도 차이가 크게 남았지만, 제 손이 닿는 것은 크기 쪽입니다.
오늘 쓰는 코딩 도구에 “ok”라고만 답하게 하고 입력 토큰을 한 번 확인해 보시길 권합니다. Claude Code는 터미널에서 claude -p "ok" --output-format json 으로 실행한 뒤 usage 칸의 input_tokens, cache_creation_input_tokens, cache_read_input_tokens 세 값을 더하면 됩니다. Codex는 codex exec --json "ok" 로 실행한 뒤 마지막 줄 usage 칸의 input_tokens 하나를 보면 됩니다. 이 값에 캐시로 읽힌 양이 이미 들어 있습니다. 그 숫자가 앞으로 모든 요청의 첫 줄에 붙는 값입니다. 크다면 CLAUDE.md나 AGENTS.md처럼 늘 붙는 지시문 가운데 가끔만 필요한 것을, 필요할 때 읽는 별도 문서로 옮기는 것부터 시작할 수 있습니다.
이 글은 AI의 도움을 받아 작성했습니다.
07참고 자료
- Anthropic, “Introducing Claude Opus 5.5”, 2026-09-22. https://www.anthropic.com/claude-opus-5-5
- Anthropic, “Pricing”, Claude Platform 문서 (2026-10-01 확인). https://platform.claude.com/docs/en/about-claude/pricing
- OpenAI Developer Community, “GPT-6.1 Sol in the API: a meaningful step up in cost-performance”, 2026-09-29. https://community.openai.com/t/gpt-6-1-sol-in-the-api-a-meaningful-step-up-in-cost-performance/1402388
- SiliconANGLE, “OpenAI's GPT-6.1 Sol delivers Astra-like performance at a dramatically lower price”, 2026-09-29. https://siliconangle.com/2026/09/29/openais-gpt-6-1-sol-delivers-astra-like-performance-at-a-dramatically-lower-price/