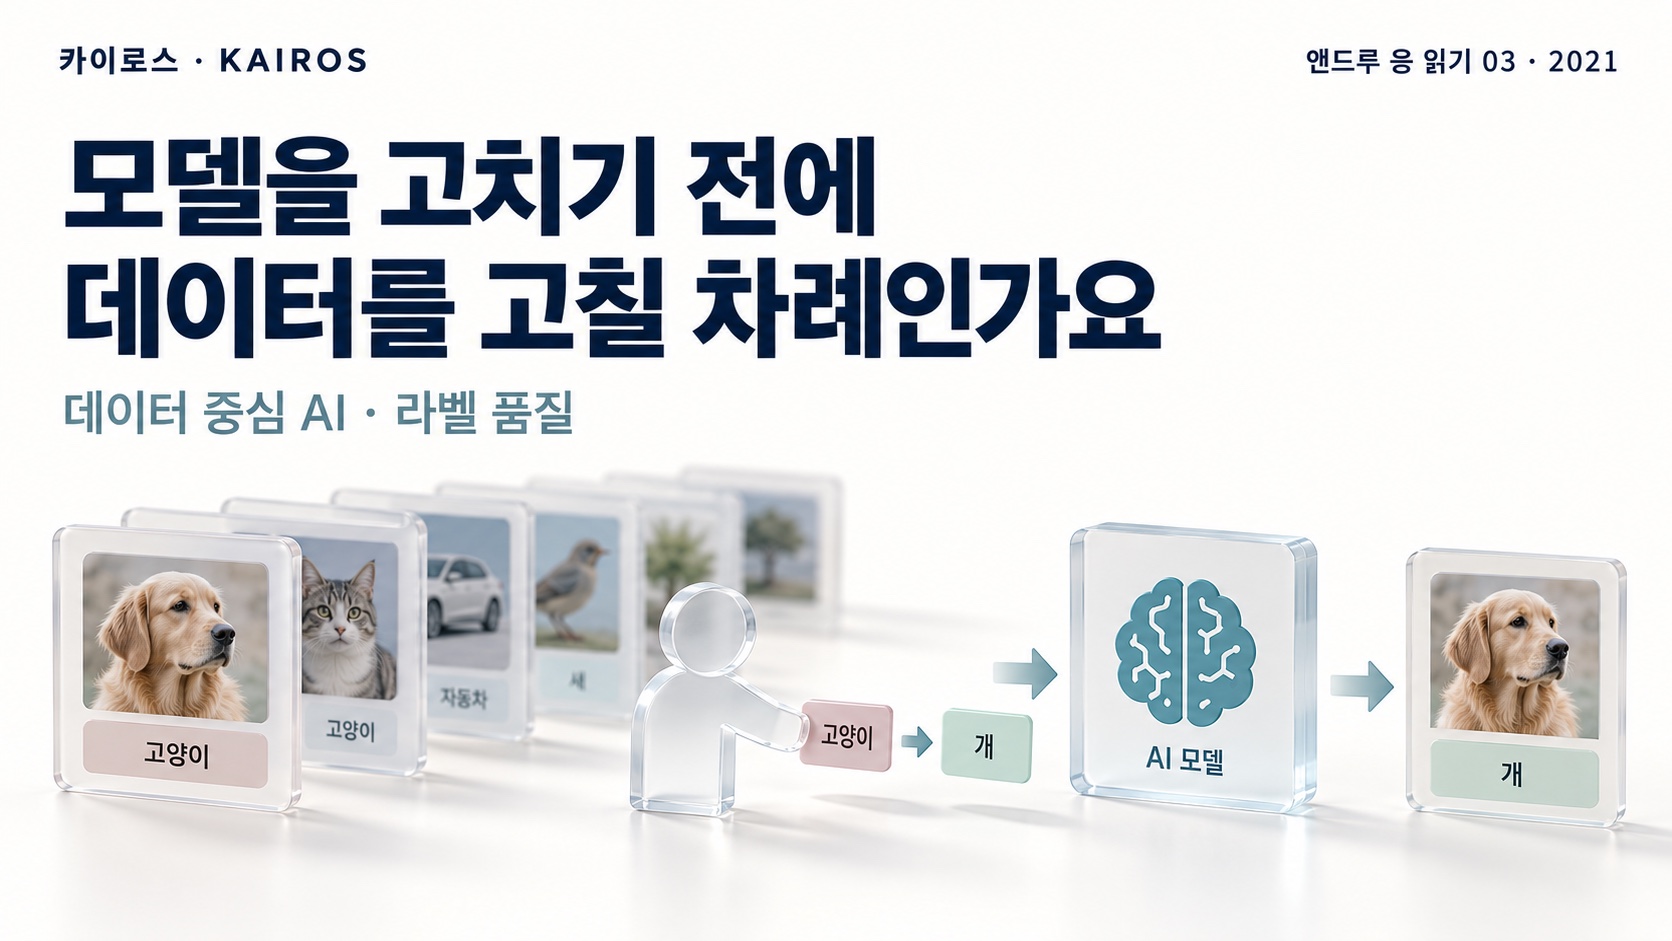
가상의 문의 자료에서 “취소 후 환불”을 누군가는 취소, 누군가는 환불로 붙였다면 모델을 다시 학습하기 전에 라벨 가이드를 고쳐야 합니다. 앤드루 응 읽기 03편은 Andrew Ng · Data-centric AI development (2021)에서 이 질문의 출발점을 찾습니다.
원문이 보여 주는 범위
응의 데이터 중심 AI 글은 모델만 바꾸는 접근에서 벗어나 데이터 품질을 체계적으로 개선하는 연구·개발 방향을 설명합니다.
모든 과제에서 데이터 수정이 모델 개선보다 낫다는 보편적 결과는 아닙니다. 자료의 사용 권한도 확인해야 합니다. 이 경계를 넘는 주장은 별도의 증거가 필요합니다.
업무에서는 무엇을 바꿀까요
여기서부터는 카이로스의 업무 적용 제안입니다. 특정 유형에서 오류가 되풀이되면 같은 라벨을 두 사람이 독립적으로 붙여 봅니다. 두 사람이 자꾸 다르게 판단한다면 데이터를 더 모으기 전에 범주 정의를 합의해야 합니다. 실제 고객 자료를 복사해 실습하지 말고 권한 있는 공개·합성 사례로 먼저 확인합니다.
판단을 나누는 질문
데이터 품질을 높인다는 말도 구체적인 조치로 바꿔야 합니다. 두 사람이 같은 사례에 다른 라벨을 붙였다면 추가 수집보다 범주 정의가 먼저일 수 있습니다. 합의 후 같은 사례를 다시 판정해 불일치가 줄었는지 확인하면, 수정이 실제로 기준을 선명하게 했는지 볼 수 있습니다.
이번 주 과제
오류 세 건의 라벨을 두 사람이 독립 판정하고 불일치 이유와 수정할 정의를 기록합니다.
완료 기준은 다른 담당자가 입력·판정 기준·보류 이유를 보고 같은 결론에 도달할 수 있는지입니다. 근거가 부족하면 결론 대신 확인할 질문을 남깁니다.
이 글은 AI의 도움을 받아 작성했습니다. 원문의 주장과 카이로스의 해석을 구분했으며, 업무 장면은 합성 사례입니다.
AI의 도움을 받아 작성하고 원문 주장과 업무 해석을 구분했습니다. 대표 이미지는 카이로스가 생성한 개념 이미지이며 실제 연구 도식이 아닙니다.