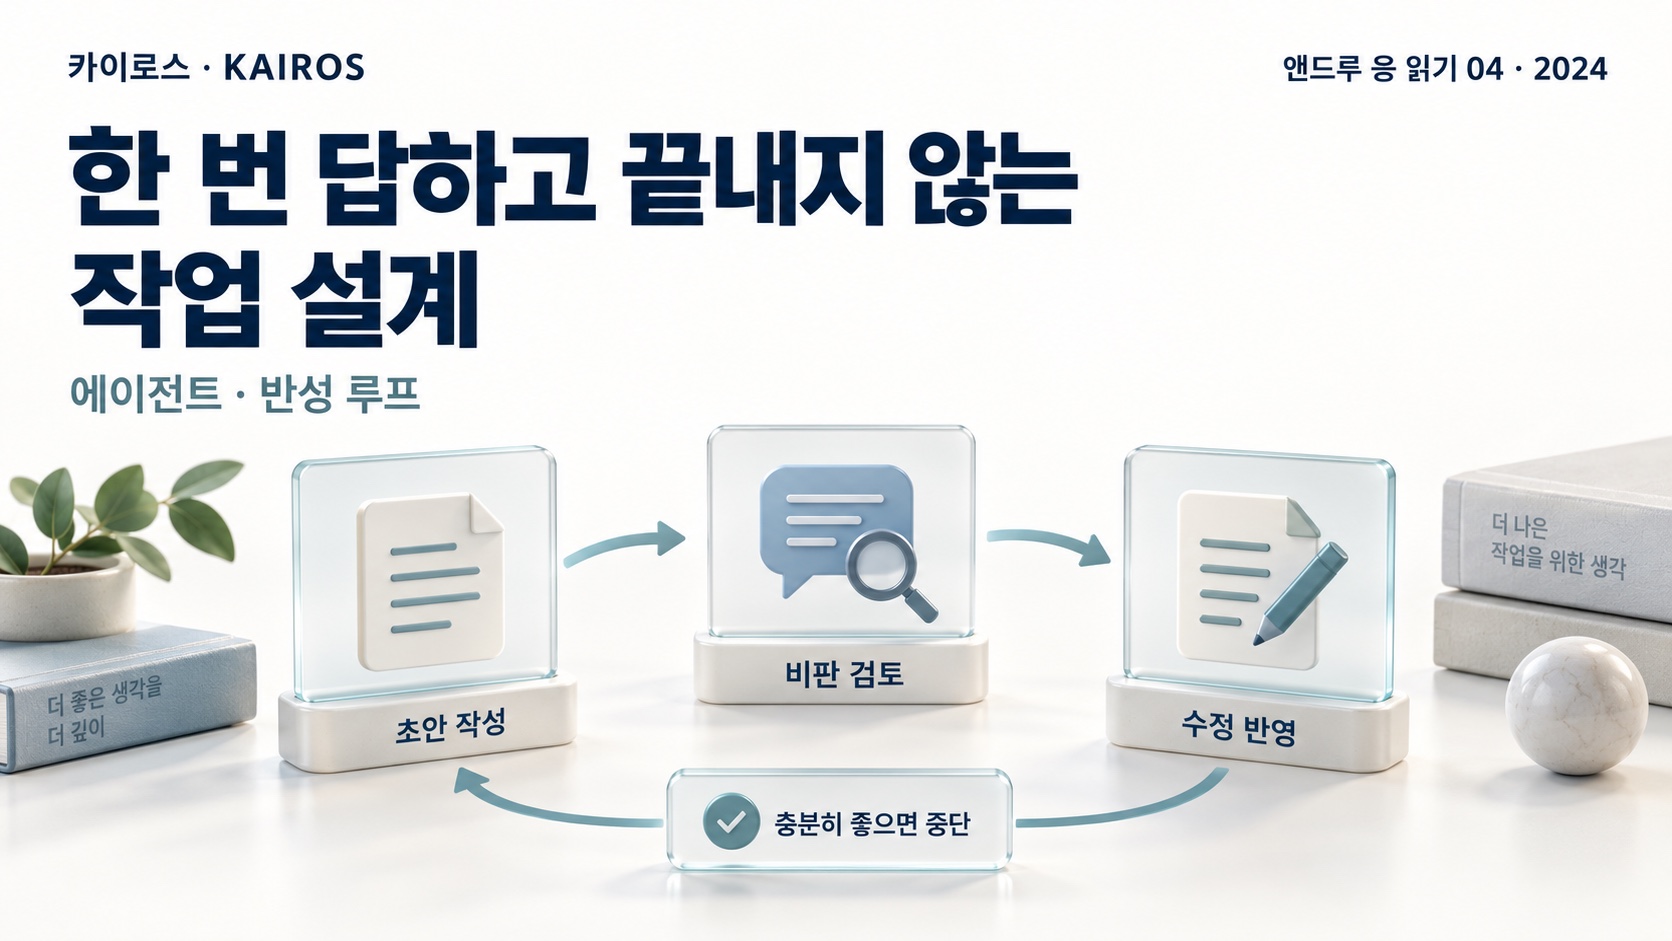
가상의 회의록 요약에서 첫 답이 결정과 제안을 섞었다면 두 번째 단계에서 원문 문장과 분류 기준을 대조하게 합니다. 앤드루 응 읽기 04편은 Andrew Ng · How agents can improve LLM performance (2024)에서 이 질문의 출발점을 찾습니다.
원문이 보여 주는 범위
응의 글은 에이전트 워크플로에서 반성, 도구 사용, 계획 같은 반복 구조를 소개하며 한 번의 응답보다 여러 단계를 거치는 접근을 논의합니다.
단계를 추가하면 언제나 더 정확하거나 저렴해진다는 뜻은 아닙니다. 검토 기준이 없으면 같은 오류를 반복할 수 있습니다. 이 경계를 넘는 주장은 별도의 증거가 필요합니다.
업무에서는 무엇을 바꿀까요
여기서부터는 카이로스의 업무 적용 제안입니다. AI 초안 뒤에 검토 질문 한 번을 넣고 수정 전후를 비교합니다. 회의록이라면 결정·제안·보류가 섞였는지 원문 문장으로 돌아가 확인합니다. 두 번째 응답이 길어졌다고 개선된 것은 아닙니다. 누락이 실제로 줄었는지와 검토 비용을 함께 봅니다.
판단을 나누는 질문
반성 단계를 추가했을 때는 수정된 문장의 수가 아니라 틀린 판단이 줄었는지 봅니다. 회의록에서 제안을 결정으로 잘못 적은 사례를 정해 첫 답과 재검토 답을 같은 원문에 대조합니다. 수정 과정이 더 오래 걸렸다면 그 비용도 함께 적어 반복 단계의 가치를 판단합니다.
이번 주 과제
AI 업무 하나에 검토 단계를 추가하고 바뀐 항목과 여전히 틀린 항목을 각각 기록합니다.
완료 기준은 다른 담당자가 입력·판정 기준·보류 이유를 보고 같은 결론에 도달할 수 있는지입니다. 근거가 부족하면 결론 대신 확인할 질문을 남깁니다.
이 글은 AI의 도움을 받아 작성했습니다. 원문의 주장과 카이로스의 해석을 구분했으며, 업무 장면은 합성 사례입니다.
AI의 도움을 받아 작성하고 원문 주장과 업무 해석을 구분했습니다. 대표 이미지는 카이로스가 생성한 개념 이미지이며 실제 연구 도식이 아닙니다.