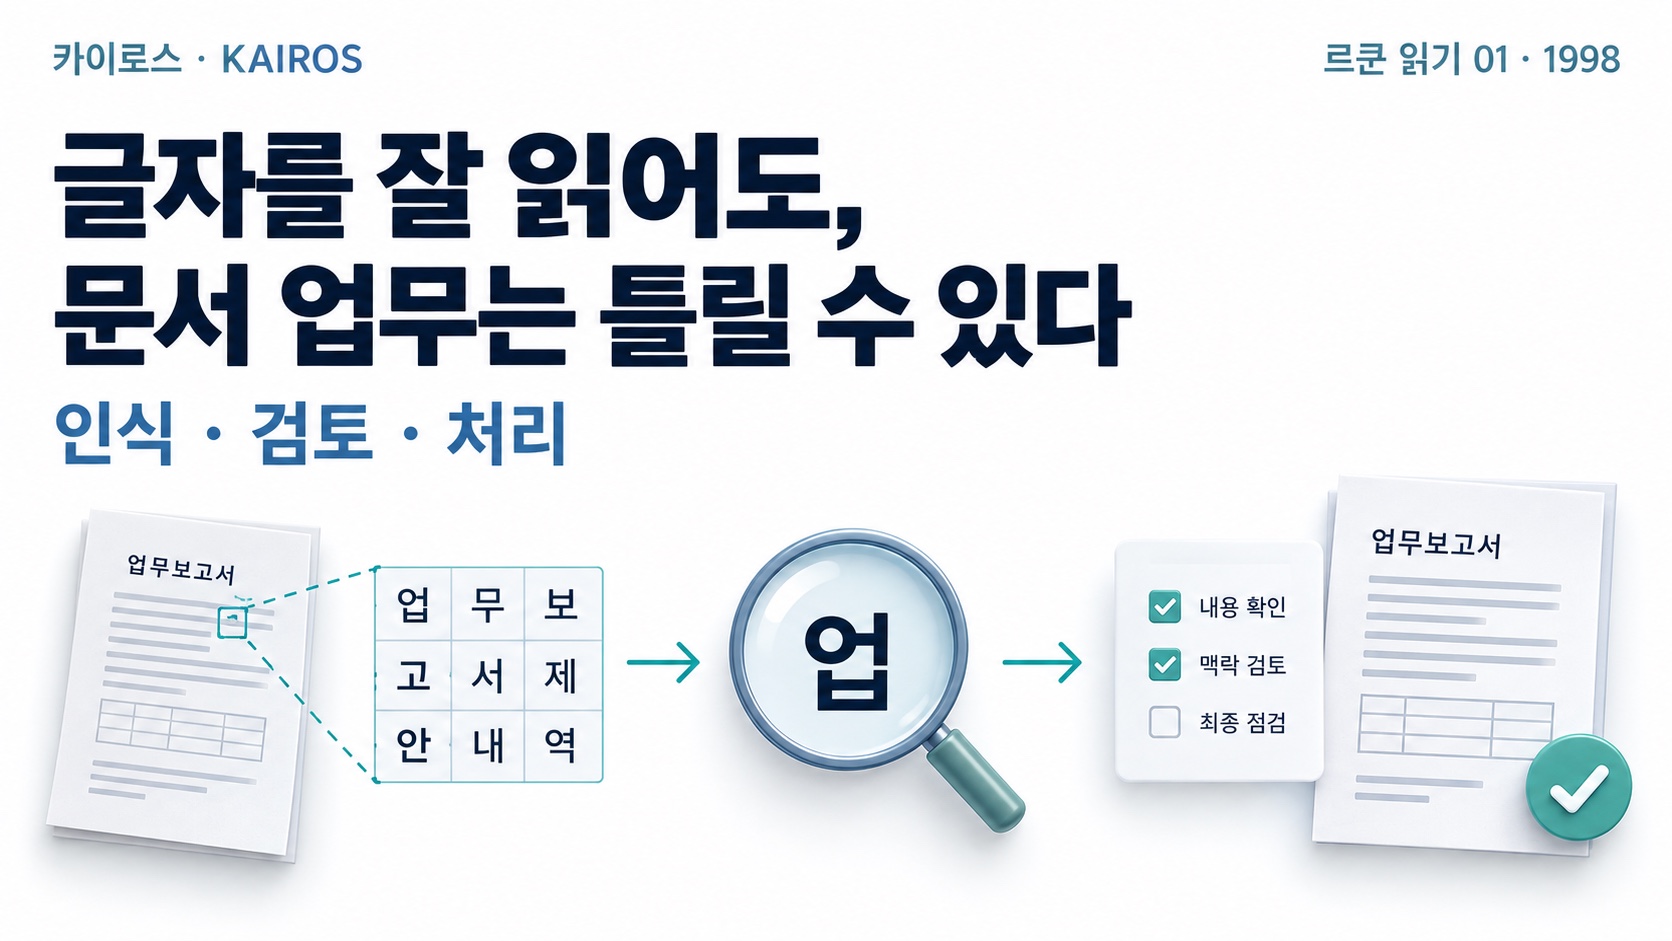
스캔 문서에서 글자를 정확히 뽑아낸 화면을 보면 자동화가 거의 끝난 듯합니다. 그런데 한 문서의 금액을 다른 거래의 금액 칸에 넣거나, 이름은 읽었지만 그 이름이 누구의 것인지 놓치면 업무는 실패합니다. 부분 기능의 정확도와 전체 업무의 성공은 다른 질문입니다.
르쿤 읽기는 얀 르쿤, 레옹 보투, 요슈아 벤지오, 패트릭 하프너의 1998년 문서 인식 논문에서 시작합니다. 그들의 연구를 오늘의 모든 문서 AI에 적용 가능한 처방으로 읽기보다, 복수의 단계를 하나의 결과로 평가하려는 시도로 읽겠습니다.
논문은 글자 분류와 문서 전체 흐름을 함께 다뤘습니다
저자들은 손글씨 숫자 인식에 여러 방법을 비교하고, 합성곱 신경망의 성능을 보고했습니다. 그러나 논문은 글자 하나의 분류에서 멈추지 않습니다. 실제 문서 인식에는 필드 추출, 분할, 인식, 언어 모델 같은 모듈이 연결됩니다. 저자들은 이런 모듈을 전체 성능에 맞춰 학습하는 방법을 제시하고 수표를 읽는 시스템을 설명했습니다. 이것은 당시의 문서 인식 연구와 적용 사례입니다.
논문에서 우리가 볼 부분은 단일 모델의 성적표만이 아닙니다. 모듈마다 좋아 보여도 마지막 결과가 틀릴 수 있기 때문에, 저자들은 전체 결과를 평가 문제로 다뤘습니다.
업무 자동화의 검사 위치를 끝까지 그려 봅니다
여기서부터는 카이로스의 해석입니다. 예를 들어 영수증 처리 절차를 생각해 보겠습니다. 합성한 예시입니다. 글자를 읽고, 거래처와 금액을 구분하고, 내부 기준에 맞게 분류하고, 담당자가 승인한 뒤 장부에 남깁니다. 각 단계는 나름의 성공을 주장할 수 있지만, 마지막 거래가 잘못 기록되면 앞 단계의 높은 점수만으로 안심할 수 없습니다.
| 단계 | 부분 성공처럼 보이는 것 | 마지막에 확인할 것 |
|---|---|---|
| 글자 인식 | 숫자를 모두 읽음 | 금액이 올바른 거래와 연결됐는가 |
| 항목 추출 | 거래처 칸이 채워짐 | 법인명과 개인 이름을 구분했는가 |
| 분류·승인 | 자동 분류가 끝남 | 승인 근거와 수정 경로가 남았는가 |
이 표는 르쿤의 알고리즘을 업무 규칙으로 옮긴 것이 아닙니다. 한 단계의 정답률이 전체 업무의 책임을 대신하지 않는다는 점을 확인하기 위한 도구입니다.
이번 주 과제: AI가 들어간 업무 흐름을 끝까지 그립니다
현재 사용 중인 자동화 하나를 골라 입력 → 추출 → 판단 → 확인 → 기록으로 표시해 보세요. 실제 단계가 다르면 이름을 바꿔도 됩니다. 각 단계 아래에 실패했을 때 누가 발견하는지를 적고, 맨 끝에는 “최종 기록이 틀렸을 때 되돌릴 수 있나?”를 질문으로 남깁니다.
완료 기준은 도식의 완성도가 아닙니다. 부분 기능의 점수와 실제 업무의 오류를 따로 말할 수 있는가입니다. 다음 편에서는 모델이 무엇을 표현으로 배우는지 살펴봅니다.
이 글은 AI의 도움을 받아 작성했습니다. 원문 연구와 업무 사례의 범위를 구분했습니다.
AI의 도움을 받아 작성하고 원문 주장과 업무 해석을 구분했습니다. 대표 이미지는 카이로스가 생성한 개념 이미지입니다.