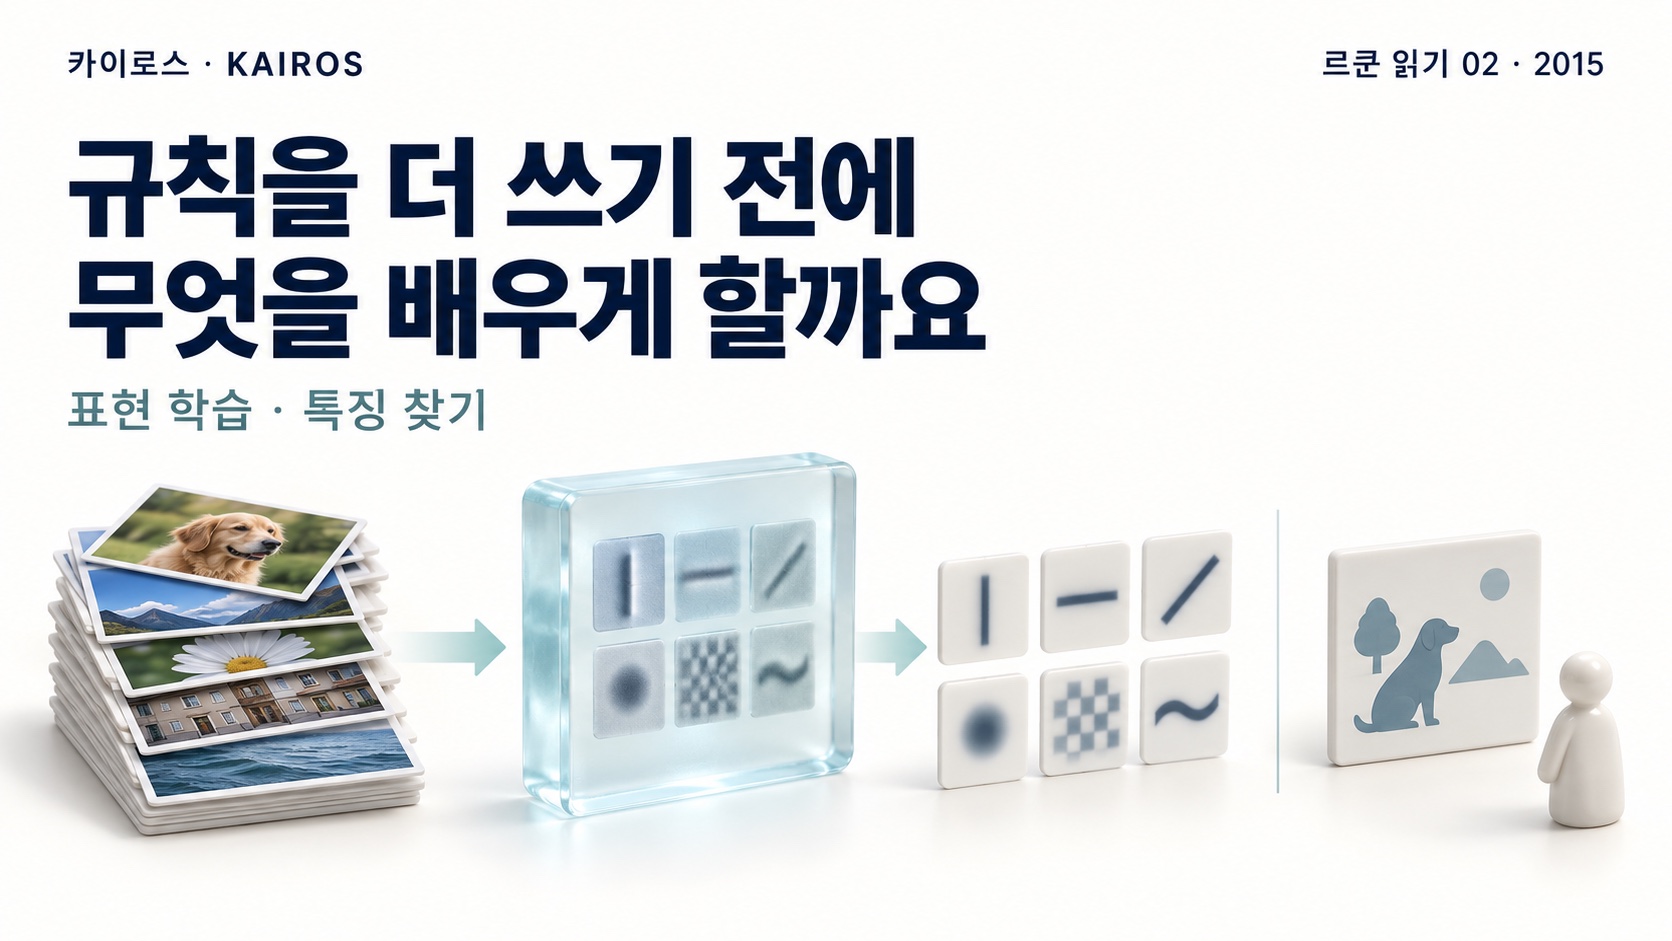
가상의 문의 팀은 다양한 표현을 같은 의도로 묶는 데 AI를 쓰더라도 환불 기간은 승인된 정책에서 가져와야 합니다. 얀 르쿤 읽기 02편은 LeCun, Bengio, Hinton · Deep learning (2015)에서 이 질문의 출발점을 찾습니다.
원문이 보여 주는 범위
르쿤·벤지오·힌턴의 공동 리뷰는 딥러닝을 여러 층의 표현을 학습하는 접근으로 설명합니다. 사람이 특징을 전부 손으로 설계해야 하는 부담을 줄입니다.
공동 저작을 르쿤의 단독 주장으로 바꾸지 않습니다. 학습이 과제 정의와 데이터 품질 문제를 없애지는 않습니다. 이 경계를 넘는 주장은 별도의 증거가 필요합니다.
업무에서는 무엇을 바꿀까요
여기서부터는 카이로스의 업무 적용 제안입니다. 다양한 말투에서 의도를 읽는 일은 학습으로 보조할 수 있습니다. 그러나 환불 기간이나 보상 승인처럼 조직이 책임져야 하는 규칙은 별도로 관리해야 합니다. 표현 학습이 정책 변경을 자동으로 반영한다고 가정하지 않습니다. 모델이 틀린 사례는 입력 표현 문제인지 규칙 문제인지 나눠 봅니다.
판단을 나누는 질문
규칙을 늘리기 전에 입력에서 어떤 구별이 필요한지 확인합니다. 문서의 글자를 읽는 업무라면 양식이 달라도 같은 필드를 찾는지, 비슷한 단어를 다른 의미로 써야 하는지 살펴봅니다. 내부 표현을 학습한다는 연구 설명과 우리 업무에서 정답 기준을 사람이 정한다는 책임을 혼동하지 않습니다.
이번 주 과제
규칙 기반 업무에서 학습할 표현 패턴 둘과 사람이 승인할 정책 규칙 둘을 적습니다.
완료 기준은 다른 담당자가 입력·판정 기준·보류 이유를 보고 같은 결론에 도달할 수 있는지입니다. 근거가 부족하면 결론 대신 확인할 질문을 남깁니다.
이 글은 AI의 도움을 받아 작성했습니다. 원문의 주장과 카이로스의 해석을 구분했으며, 업무 장면은 합성 사례입니다.
AI의 도움을 받아 작성하고 원문 주장과 업무 해석을 구분했습니다. 대표 이미지는 카이로스가 생성한 개념 이미지이며 실제 연구 도식이 아닙니다.